
AI 源匹配
让人工智能检测不再靠猜测。
找出原始出处。
什么是AI源匹配?
AI 源匹配的工作原理是利用大型语言模型 (LLM) 固有的结构性缺陷。由于 LLM 依赖于固定的训练数据,因此它们容易生成重复内容和自我抄袭。
应对人工智能重复和抄袭问题
AI 源匹配利用语言学习模型 (LLM) 的重复性,创建了一个庞大的已确认 AI 生成内容库。通过主动存档这些输出,我们可以明确记录文本的来源,并以清晰的并排比较方式展示标记的 AI 内容的具体来源。
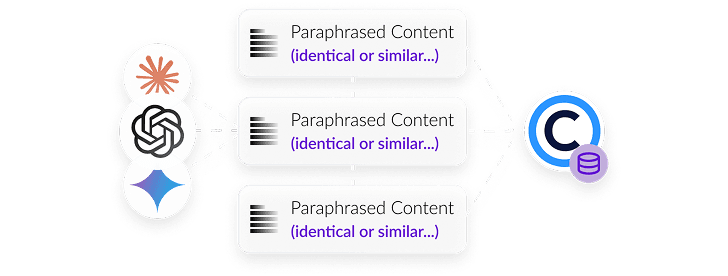
确保内容的完整性和原创性
AI Source Match 是一款专有的基于来源的内容完整性验证系统,并结合了 AI 检测功能。它解决了内容原创性的核心问题,消除了简单百分比或“是/否”评分带来的歧义。

应对人工智能重复和抄袭问题
AI 源匹配利用语言学习模型 (LLM) 的重复性,创建了一个庞大的已确认 AI 生成内容库。通过主动存档这些输出,我们可以明确记录文本的来源,并以清晰的并排比较方式展示标记的 AI 内容的具体来源。
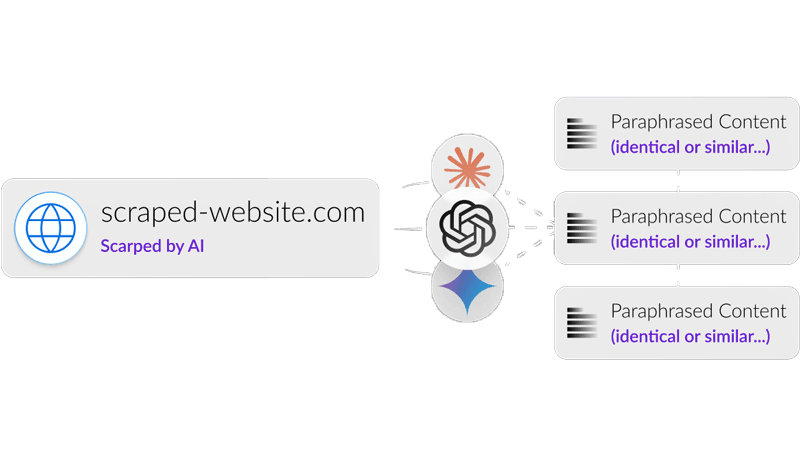
确保内容的完整性和原创性
AI Source Match 是一款专有的基于来源的内容完整性验证系统,并结合了 AI 检测功能。它解决了内容原创性的核心问题,消除了简单百分比或“是/否”评分带来的歧义。

针对非原创内容
AI 源匹配旨在忽略常用的 AI 润色和风格编辑(这是误报的主要原因),而只关注非原创内容。

AI 来源匹配的工作原理是什么?
AI Source Match 利用专有存储库和相似性匹配技术来验证提交文本的原创性。Copyleaks AI 存储库是支持可验证检测的专有数据库。它通过捕获和存档已确认的 AI 撰写材料而构建。该存档包含:

发布内容
公开内容、开放获取期刊和超过 16,000 种学术期刊已被标记为可能是人工智能生成的内容。

已存档的LLM输出
Copyleaks 数据团队通过持续的 LLM 提示在内部生成了数百万条输出结果,并记录在我们的数据库中。
透明度
当文本通过AI检测器提交时,系统会将其与AI库进行比对。该工具旨在检测直接重复和语义相近的匹配(释义)。
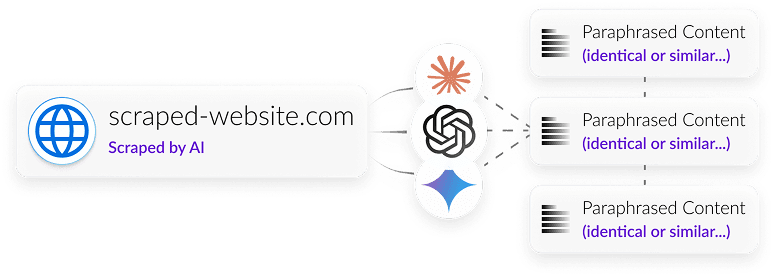

揭示人工智能的起源
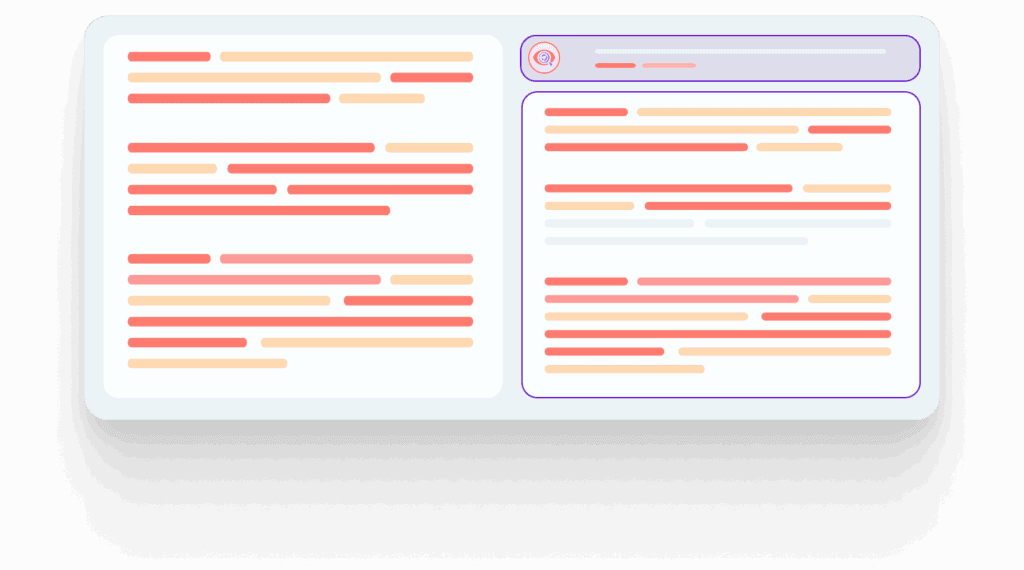
最后,与传统的抄袭检测报告一样,AI Source Match 以无与伦比的透明度呈现检测结果。该系统会将文本与 AI 生成内容的原始存档或在线来源并排显示。这种方法确保了存储库作为权威的来源集合,使我们能够自信地将非原创文本与其 AI 相关来源进行匹配。
超越怀疑,Copyleaks 的优势
Copyleaks 弥补了竞争对手的不足,将模糊的评分转化为内容独特性的并排验证。其他 AI 检测器仅生成统计百分比或简单的“是/否”结果,缺乏上下文信息,而 Copyleaks 则会显示文档,以便评估内容的原创性和完整性。
减轻人工智能检测带来的挫败感
将轻微的AI润色标记为违反完整性的行为。通过识别内容并将其与原始来源进行匹配,AI来源匹配功能确保您的审核工作完全集中在证实内容的原创性上,而不是低风险行为。
Copyleaks API
Copyleaks API 功能强大,专为可靠性和可扩展性而设计。购买包含 AI 检测器和抄袭检测器的完整内容完整性套件后,即可在 API 中使用 AI 源匹配功能。

AI检测方式的创新
AI 源匹配功能提供上下文信息:我们会高亮显示匹配的文本,并向您展示确切的来源 URL 或已存档的 AI 文本。这可以将统计猜测转化为内容原始来源的可视化报告。

无缝集成
Copyleaks API 可无缝集成到您现有的基础架构中,提供专注且可验证的内容完整性解决方案。

建立在剽窃信心之上
AI Source Match 的核心功能——并排显示来源匹配结果——直接建立在我们久经考验的抄袭检测器之上。正因如此,结果才如此可靠且无可辩驳。
为什么人工智能来源匹配很重要
在人工智能生成内容充斥互联网的时代,对可验证上下文的需求从未如此迫切。人工智能来源匹配至关重要,因为它从根本上解决了最重大的完整性风险,克服了过时检测模型的缺陷。

降低高风险
AI 源匹配功能确保您的资源仅用于非原创内容,即文本被重新利用或复制自其他来源的内容。这可以保护您的组织或学术机构免受知识产权责任和内容纠纷的影响。

源映射
我们用来源映射取代了含义模糊的AI检测概率评分。通过将每次扫描结果与我们专有的AI生成内容库进行交叉比对,我们可以对标记文本进行并排比较。这种透明化流程将疑似AI标记转变为有据可查的来源匹配。

可捍卫的完整性
AI Source Match 通过提供源文档,使您能够做出有理有据、透明且公平的内容决策,无论是执行学术政策还是创作原创内容。
谁需要人工智能匹配数据源?
提交您的内容后,AI 源匹配功能会将其与我们专有的已确认 AI 生成素材库进行比对。系统会立即识别匹配项,并在标记文本旁边显示确切来源,确保完全透明。

企业
AI Source Match 提供合规性、知识产权保护和内容完整性所需的文档化背景信息。

教育
抛开猜疑。AI Source Match 为教育工作者提供必要的原始文献,以支持公平的学生对话、政策执行,以及教授批判性思维和在法学硕士时代持续培养原创思维。
AI检测方式与众不同。
获取演示,了解 Copyleaks AI Source Match 如何提供文档以自信地确认原创性。
AI 源匹配常见问题解答
没有任何检测系统能够完全绕过,但Copyleaks的技术比统计评分工具更能有效规避漏洞。我们的技术针对的是LLM重复这种结构性缺陷,这种缺陷无法通过简单的编辑或改写来掩盖内容。
不同工具和内容类型的准确性可能有所不同。Copyleaks 的独特之处在于其专注于可验证的文档。我们的解决方案并非仅仅提供 AI 检测的概率评分,而是提供并排匹配结果,显示原始来源。这使得用户更容易证实其发现,并就内容的完整性和原创性做出明智的判断。
人工智能的兴起带来了一个严重的诚信风险:未经授权的重复使用。问题不再仅仅在于人工智能是否能够写作,而在于它复制了什么。随着人工智能内容不断充斥互联网,侵权和非原创内容的风险极高。
AI Source Match 旨在解决这一结构性问题。AI Source Match 利用了 LLM 的一个核心漏洞:由于训练数据固定,LLM 容易生成重复内容和自我抄袭。
资料库:Copyleaks 多年来一直主动存档这些输出内容,创建了一个专有的、经确认由人工智能编写的材料资料库。
验证:当提交的内容与此存储库(或其他先前已发布且疑似 AI 内容)匹配时,系统会确认该文本并非唯一。
这种有据可查的验证(并排比对)是关键区别:它立即将调查结果从可质疑的可能性转变为可辩护的、有据可查的事实。
AI 源匹配根据来源的完整性风险对内容进行分类:
独特内容:与已知的 AI 输出或已发表的材料没有实质性重复的文本。
未注明来源的内容(来源匹配):与已存档的LLM输出或现有在线AI生成文本相匹配的文本。这表明该内容并非独一无二。
AI源代码库通过抓取众多领先的生成式AI平台的输出构建而成,包括但不限于GPT-3.5、GPT-4、Claude和Gemini等模型。即使某个特定模型未被明确列出,系统通常也会抓取新模型生成的独特文本序列。我们会定期扩展索引的模型输出,以跟上新模型的发布。
Copyleaks AI Source Match 旨在识别因 LLM 重复而导致的未注明出处的内容。它不关注:
简单的手动编辑(例如,在 MS Word 中编辑)。
基本语法工具引起的细微风格变化。
目前不在 AI 资源库范围之内的语言的文本(AI 资源库主要关注英语)。
可能有以下几个原因:
新的 LLM 输出:该文本是由一个全新的模型或提示创建的,该模型或提示尚未被索引并存档到存储库中。
文本量过小:提交的文本量太少,数据量不足以让系统与存储库进行可靠的匹配。为了获得最高的可靠性,请尽可能提交完整的原始文本。
AI 源匹配技术通过解决非原创性 AI 重复内容的特定风险,弥合了传统检测方法之间的鸿沟。标准的抄袭检测方法搜索与已发表的人类作品完全相同或完全一致的内容,而标准的 AI 检测方法则基于语言模式提供似然性评分。相比之下,AI 源匹配技术专门针对已知的 LLM 输出和被识别为 AI 在线生成的材料。这种独特的组合使 Copyleaks 能够提供可验证的来源文档——类似于抄袭报告——这些文档会并排显示,以确认内容并非原创,因为它重复了已存档的 AI 输出,从而在以往只有怀疑的情况下提供了确凿的上下文信息。
不。AI Source Repository 是由 Copyleaks 管理的专有数据库,不对外公开。它包含敏感的、经过索引的内容,这些内容来源于我们的内部提示和网络爬虫,从而确保其作为可验证文档来源的完整性和独特价值。