评估 Copyleaks 文本审核的准确性
详细方法论
我们认为,充分透明地披露文本审核模型的准确率、误报率和漏报率、需要改进的方面等信息至关重要,这有助于确保模型得到负责任的使用和推广。这份全面的分析旨在确保文本审核模型测试方法的完全透明。
执行摘要
Copyleaks 文本审核模型 v1 接受了双人盲评,共使用了 120,000 篇英文文本(50% 违规,50% 不违规),这些文本与训练数据集完全分离。
评估结果表明,该模型能够以非常高的召回率识别有害内容,同时几乎不会将无辜文本标记为有害文本。
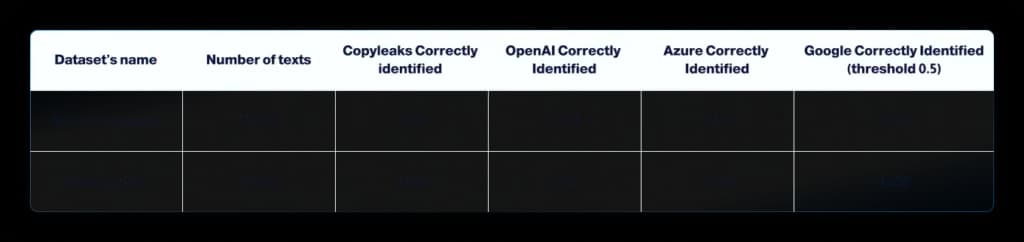
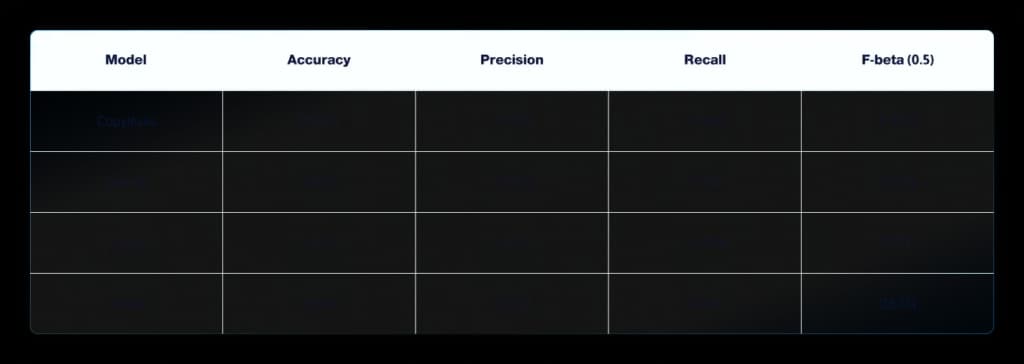
当使用三个领先的商业审核 API(OpenAI、Azure 和 Google)以默认阈值处理相同的数据集时,Copyleaks 产生的误报和漏报更少,在关键指标上具有 4%-30% 的优势。
关键数据(QA 测试集,N = 20,000)
- 准确率:99.23%
- 准确率:99.97%(在10,000条非违规文本中出现3个误报)
- 召回率(TPR):98.48%
- F-Beta(0.5) 得分:99.67%
方法论
为了获得模型性能的客观评价,我们采用了双团队盲测的方式。数据科学团队和测试团队完全独立工作,使用不同的机器、不同的脚本,并且不共享任何数据。
1. 测试集构建
数据科学测试集
- 10万条英文段落(5万条不违规/5万条违规)
- 文本样本从四个经过审核的来源中随机抽取(不放回):公开的社交媒体泄露内容、新闻文章、公共领域文献以及Copyleaks生成的极端案例。所有材料均属于公共领域或已获得明确的许可。
- 与两位外部法学硕士进行交叉核对;仅保留一致同意的项目。
- 涵盖 Copyleaks 所有政策类别
- 标签确定性筛选:仅保留审核状态为 100% 明确的段落;任何状态模糊的文本均被剔除。这最大限度地保证了直接比较的公平性,并消除了真实性中的主观因素。
QA 测试集
- 由质量保证部门独立撰写的20,000篇英文文章(10,000篇不违规/10,000篇违规)。
- 最小长度为 10 个字符;其他方面与 DS 集相同,包括采样、标签、许可来源、100% 确定性规则和类别协议。
数据科学数据集严格地与用于训练的原始语料库分开。问答数据集包含在模型训练后特意编写的段落;这些文本在训练过程中从未出现过,也并非来自训练语料库。
2. 工具链和执行细节
- Copyleaks API v1,查询日期:2025年6月24日
- 竞争对手的端点(于 2025 年 6 月 24 日使用相同的预处理方法查询)
- OpenAI Moderation v2,默认阈值
- Azure AI 内容安全版本 2025-06-15
- Google Perspective API 版本 2025-06-12,毒性阈值 = 0.50
- 预处理:保留表情符号,不进行词干提取或转换为小写
- 对于每次运行,我们记录原始 JSON 响应,得出二元结果,构建混淆矩阵(TP、FP、TN、FN),然后计算准确率、精确率、召回率、TNR 和 F-Beta(0.5)。
审核类别定义
以下定义用于描述调节类别:
- 成人内容:对性行为或性行为的露骨描述、提及或描绘,旨在引起性兴奋。
- 有害语言:指带有侮辱、贬低或侮辱意味的有害语言,不一定针对特定个人。这包括任何旨在造成情感伤害的语言。
- 暴力:煽动或美化身体伤害或损伤的语言。
- 粗俗用语:使用强烈或冒犯性的脏话。
- 自残:鼓励或使自残行为正常化的言论。
- 骚扰:有针对性地侮辱或贬低特定个人或群体,重点关注其个人特征或信仰的辱骂或贬低行为。
- 仇恨言论:基于固有特征妖魔化或煽动对某个群体或个人的伤害的语言,通常呼吁暴力或系统性歧视。
- 药物使用:提及、描述或支持在有害情况下使用、滥用或分发药物,包括非法物质或滥用合法药物。
- 枪支:讨论枪支和其他武器的使用、持有或分发的内容,尤其是当此类讨论可能助长或导致暴力或不安全行为时。
- 网络安全:与计算机安全相关的内容,包括关于黑客攻击、数据泄露以及入侵数字系统或获取未经授权访问权限的措施的讨论。
- 其他:任何其他被认为不恰当、有害或冒犯性的内容,不属于上述类别。
指标定义
本文本审核任务中使用的指标包括:
1. 混淆矩阵:一个总结模型性能的表格,显示:
- 真阳性 (TP) :被正确识别为需要审核的违规文本。
- 误报(FP) :将未违规的文本错误地识别为需要审核。
- 真阴性(TN) :正确识别为不需要审核的非违规文本。
- 误判(FN) :违规文本被错误地识别为不需要审核。
2. 准确率:被正确分类的实例(包括真阳性和真阴性)占所评估文本总数的比例。
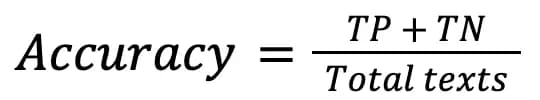
3. 真阴性率 (TNR) :实际为阴性的实例中被正确识别为阴性的比例。在文本审核领域,TNR 用于衡量模型对非违规文本的处理性能。
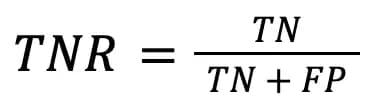
4. 真正率 (TPR) / 召回率:实际为正例中被正确识别为正例的比例。在文本审核领域,TPR 用于衡量模型对违规文本的识别性能。
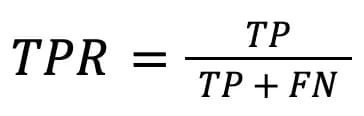
5. 精确率:正确预测为阳性结果的比例,占所有阳性预测结果的比例。在文本审核领域,精确率衡量的是模型标记违规内容的可靠性;它告诉我们,模型识别出的违规文本中,有多少最终被审核通过。
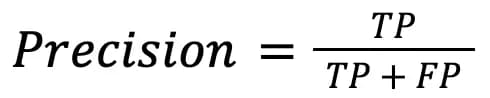
6. F-beta 分数:精确率和召回率的加权调和平均值,其中 beta 参数设置为优先考虑精确率。这种优先考虑有助于降低假阳性率。
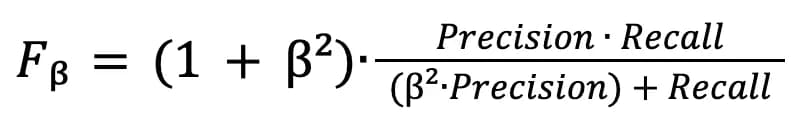
结果
数据科学团队
混淆矩阵
质量保证团队
质量保证测试指标汇总:
总体准确率:0.9923
精度:0.9997
召回率:0.9848
F-beta (β = 0.5) : 0.9967
直接对决基准
局限性
- 语言范围:本模型及其评估仅涵盖英语。
- 上下文范围:审核每次仅针对一个“段落”,一个段落是指包含一定数量词元的独立文本块。系统不会跨段落、章节或对话轮次保存信息;因此,诸如“正如我们之前解释过的”之类的表述或依赖于先前上下文的代词可能会被遗漏。
- 模态范围:本产品仅评估文本;不包括图像、音频或视频输入。