Valutazione dell'accuratezza della moderazione dei testi di Copyleaks
Una metodologia dettagliata
Riteniamo fondamentale essere completamente trasparenti in merito all'accuratezza del nostro modello di moderazione del testo, ai tassi di falsi positivi e falsi negativi, alle aree di miglioramento e ad altri aspetti, al fine di garantirne un utilizzo e un'adozione responsabili. Questa analisi completa mira a garantire la massima trasparenza sulla metodologia di test del nostro modello di moderazione del testo.
Sintesi
Il modello di moderazione del testo Copyleaks v1 è stato sottoposto a una valutazione cieca da parte di due team su un totale di 120.000 testi in inglese (50% contenenti violazioni, 50% non contenenti violazioni) completamente separati dal set di dati di addestramento.
La valutazione dimostra che il modello è in grado di identificare contenuti dannosi con un'altissima precisione, non segnalando quasi mai testi innocenti.
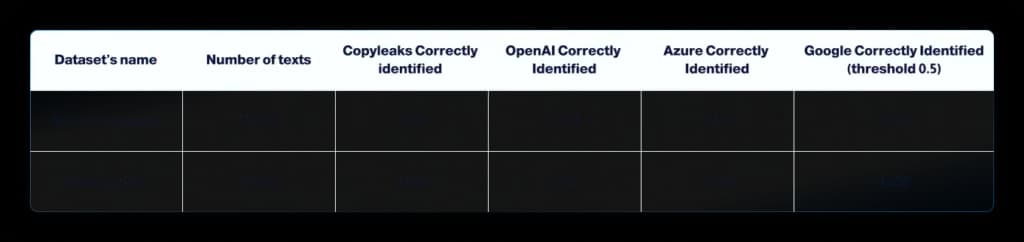
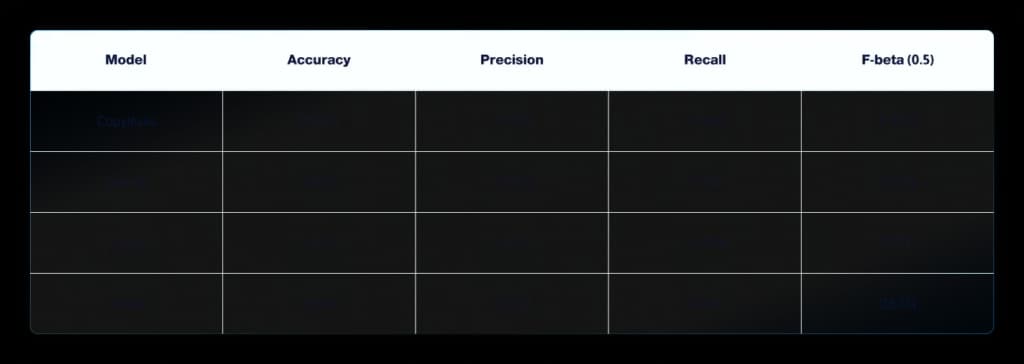
Quando lo stesso set di dati è stato elaborato tramite tre delle principali API di moderazione commerciali (OpenAI, Azure e Google) con le loro soglie predefinite, Copyleaks ha prodotto un numero inferiore di falsi positivi e falsi negativi, con un vantaggio compreso tra il 4% e il 30% su metriche chiave.
Dati chiave (set di test QA, N = 20.000)
- Precisione: 99,23%
- Precisione: 99,97% (3 falsi positivi su 10.000 testi non in violazione)
- Richiamo (TPR): 98,48%
- Punteggio F-Beta(0,5): 99,67 %
Metodologia
È stata condotta una valutazione cieca a due team, al fine di ottenere un quadro imparziale delle prestazioni del modello. I team di Data Science e QA hanno lavorato in completo isolamento, utilizzando macchine diverse, script diversi e senza condividere dati.
1. Costruzione dei set di test
Set di test per la scienza dei dati
- 100.000 brani in inglese (50.000 non in violazione / 50.000 in violazione)
- Testi campionati casualmente senza reimmissione da quattro fonti verificate: dump pubblici dei social media, articoli di notizie, letteratura di pubblico dominio e casi limite generati da Copyleaks. Tutto il materiale è di pubblico dominio o utilizzato sotto licenze esplicite.
- Verifica incrociata con due LLM esterni; vengono mantenuti solo gli elementi unanimi
- Copertura per tutte le categorie di polizze Copyleaks
- Filtro di certezza dell'etichetta: sono stati mantenuti solo i passaggi il cui stato di moderazione era definitivo al 100%; i testi al limite sono stati scartati. Ciò massimizza l'equità nei confronti diretti ed elimina la soggettività dalla verità oggettiva.
Set di test QA
- 20.000 brani in inglese (10.000 non in violazione / 10.000 in violazione) redatti in modo indipendente dal dipartimento di controllo qualità.
- Lunghezza minima di 10 caratteri; per il resto, stesso campionamento, etichettatura, provenienza della licenza, regola definitiva al 100% e protocollo di categoria del set DS.
Il set di dati per la scienza dei dati è stato rigorosamente escluso dai corpus originali utilizzati per l'addestramento. Il set di domande e risposte comprende brani creati appositamente dopo l'addestramento del modello; questi testi non sono mai stati utilizzati durante l'addestramento e non sono stati tratti dai corpus di addestramento.
2. Dettagli della catena di strumenti e dell'esecuzione
- API Copyleaks v1, interrogata il 24 giugno 2025
- Endpoint dei concorrenti (interrogati con la stessa pre-elaborazione il 24 giugno 2025)
- Moderazione OpenAI v2, soglia predefinita
- Build di Azure AI Content Safety del 15/06/2025
- API Google Perspective rev. 2025-06-12, soglia di tossicità = 0,50
- Pre-elaborazione: conservazione delle emoji, nessuna riduzione della radice o conversione in minuscolo.
- Per ogni esecuzione abbiamo registrato la risposta JSON grezza, derivato un verdetto binario, costruito una matrice di confusione (TP, FP, TN, FN) e quindi calcolato Accuratezza, Precisione, Richiamo, TNR e F-Beta(0.5)
Definizione delle categorie di moderazione
Per le categorie di moderazione sono state utilizzate le seguenti definizioni:
- Contenuti per adulti : descrizioni, riferimenti o rappresentazioni esplicite di atti o comportamenti sessuali intesi a suscitare eccitazione sessuale.
- Tossico : linguaggio offensivo che insulta, umilia o degrada in modo generale, non necessariamente rivolto a una persona specifica. Ciò include qualsiasi linguaggio inteso a causare danno emotivo.
- Violento : linguaggio che incita o glorifica danni o lesioni fisiche.
- Linguaggio volgare : utilizzo di parolacce forti o offensive.
- Autolesionismo : riferimenti che incoraggiano o normalizzano comportamenti autolesionistici.
- Molestie : Abuso mirato che insulta o umilia una persona o un gruppo specifico, concentrandosi su tratti personali o convinzioni.
- Discorso d'odio : linguaggio che demonizza o incita al danno nei confronti di un gruppo o di un individuo sulla base di caratteristiche intrinseche, spesso appellandosi alla violenza o alla discriminazione sistemica.
- Uso di droghe : riferimenti, descrizioni o approvazioni dell'uso, dell'abuso o della distribuzione di droghe in un contesto dannoso, comprese le sostanze illegali o l'uso improprio di farmaci legali.
- Armi da fuoco : Contenuti che trattano l'uso, il possesso o la distribuzione di armi da fuoco e altre armi, soprattutto quando tali discussioni potrebbero promuovere o causare violenza o pratiche pericolose.
- Sicurezza informatica : Contenuti relativi alla sicurezza informatica, tra cui discussioni su hacking, violazioni dei dati e misure per violare i sistemi digitali o ottenere accessi non autorizzati.
- Altro : qualsiasi altro contenuto ritenuto inappropriato, dannoso o offensivo non contemplato dalle categorie precedenti.
Definizioni delle metriche
Le metriche utilizzate in questa attività di moderazione del testo sono:
1. Matrice di confusione : una tabella che riassume le prestazioni del modello, mostrando:
- Veri Positivi (TP) : Testi che violano le regole e che sono stati correttamente identificati come bisognosi di moderazione.
- Falsi positivi (FP) : testi non lesivi delle regole identificati erroneamente come bisognosi di moderazione.
- Veri Negativi (TN) : Testi non lesivi correttamente identificati come non bisognosi di moderazione.
- Falsi negativi (FN) : Testi che violano le regole ma che vengono erroneamente identificati come non bisognosi di moderazione.
2. Accuratezza : la proporzione di casi classificati correttamente (sia veri positivi che veri negativi) rispetto al numero totale di testi valutati.
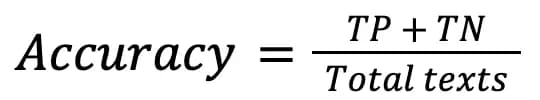
3. Tasso di veri negativi (TNR) : la proporzione di casi negativi effettivi che vengono correttamente identificati come tali. Nel contesto della moderazione del testo, il TNR misura le prestazioni del modello su testi non lesivi.
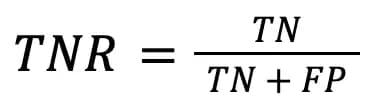
4. Tasso di veri positivi (TPR) / Richiamo : la proporzione di casi effettivamente positivi che vengono correttamente identificati come tali. Nel contesto della moderazione del testo, il TPR misura le prestazioni del modello sui testi che violano le regole.
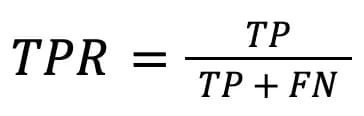
5. Precisione : la proporzione di osservazioni positive correttamente previste rispetto al totale delle previsioni positive. Nel contesto della moderazione dei testi, la precisione misura l'affidabilità del modello quando segnala i contenuti; ci dice quanti dei testi identificati come inappropriati dal modello sono stati effettivamente moderati.
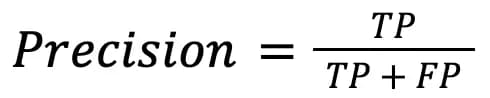
6. Punteggio F-beta : una media armonica ponderata di precisione e richiamo, in cui il parametro beta è impostato per favorire la precisione. Questa prioritizzazione contribuisce a ottenere un tasso di falsi positivi inferiore.
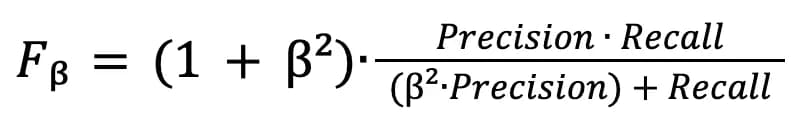
Risultati
team di Data Science
Matrice di confusione
team di controllo qualità
Riepilogo delle metriche dei test di controllo qualità:
Precisione complessiva : 0,9923
Precisione : 0,9997
Richiamo : 0,9848
F-beta (β = 0,5) : 0,9967
Confronto diretto
Limitazioni
- Ambito linguistico: questo modello e la relativa valutazione riguardano esclusivamente la lingua inglese.
- Ambito del contesto: la moderazione viene eseguita su un singolo "passaggio" alla volta, dove un passaggio è un blocco di testo autonomo con un certo numero di token. Il sistema non mantiene alcuna memoria tra passaggi, capitoli o turni di conversazione; pertanto, riferimenti come "come abbiamo spiegato in precedenza" o pronomi che dipendono dal contesto precedente potrebbero non essere rilevati.
- Ambito della modalità: questo prodotto valuta solo il testo; non sono inclusi input di immagini, audio o video.