Évaluation de la précision de la modération textuelle de Copyleaks
Une méthodologie détaillée
Nous estimons qu'il est primordial d'assurer une transparence totale quant à la précision de notre modèle de modération de texte, ses taux de faux positifs et de faux négatifs, ses axes d'amélioration, et plus encore, afin de garantir une utilisation et une adoption responsables. Cette analyse approfondie vise à garantir une transparence complète de la méthodologie de test de notre modèle de modération de texte.
Résumé exécutif
Le modèle de modération de texte Copyleaks v1 a été soumis à une évaluation à l'aveugle par une double équipe sur un total de 120 000 textes anglais (50 % en infraction, 50 % non en infraction) qui étaient complètement séparés de l'ensemble de données d'entraînement.
L'évaluation montre que le modèle peut identifier les contenus nuisibles avec un taux de rappel très élevé tout en ne signalant quasiment jamais les textes innocents.
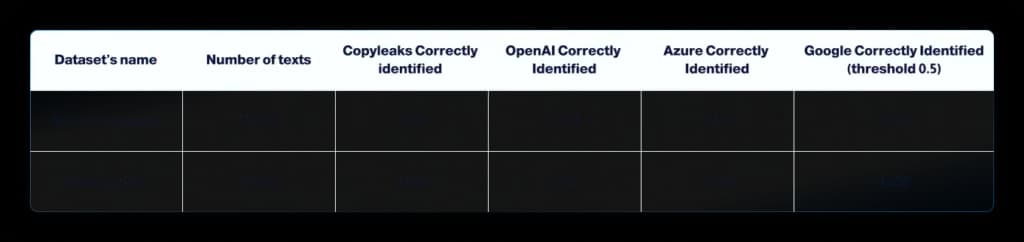
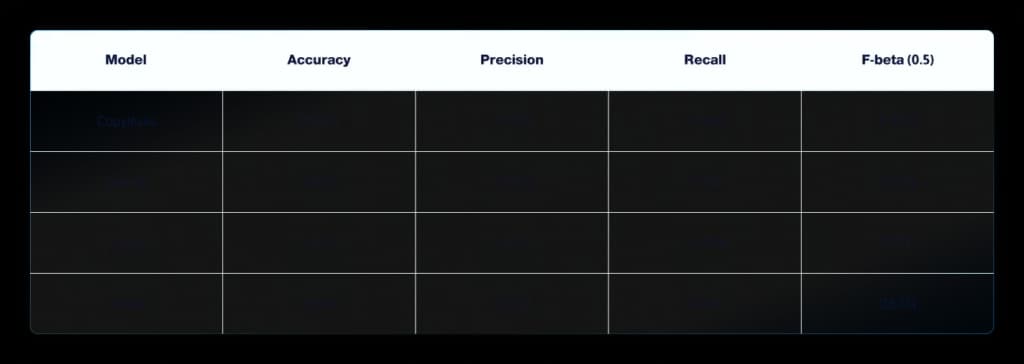
Lorsque le même ensemble de données a été traité par trois API de modération commerciales de premier plan (OpenAI, Azure et Google) à leurs seuils par défaut, Copyleaks a produit moins de faux positifs et de faux négatifs, avec un avantage de 4 % à 30 % sur les indicateurs clés.
Chiffres clés (ensemble de test QA, N = 20 000)
- Précision : 99,23 %
- Précision : 99,97 % (3 faux positifs sur 10 000 textes non enfreints)
- Rappel (TPR) : 98,48 %
- Score F-Beta(0,5) : 99,67 %
Méthodologie
Une évaluation à l'aveugle, menée conjointement par deux équipes, a permis d'obtenir une vision objective des performances du modèle. Les équipes de science des données et d'assurance qualité ont travaillé de manière totalement indépendante, utilisant des machines et des scripts différents, sans partager de données.
1. Construction des ensembles de tests
Ensemble de tests de science des données
- 100 000 passages en anglais (50 000 non-violants / 50 000 violants)
- Textes sélectionnés aléatoirement, sans remise, à partir de quatre sources vérifiées : contenus publics issus des réseaux sociaux, articles de presse, littérature du domaine public et cas particuliers générés par Copyleaks. Tous les documents sont soit dans le domaine public, soit utilisés sous licence explicite.
- Vérification croisée avec deux LLM externes ; seuls les éléments faisant l’unanimité sont conservés.
- Couverture pour toutes les catégories de polices Copyleaks
- Filtre de certitude des étiquettes : seuls les passages dont le statut de modération était définitif à 100 % ont été conservés ; les textes limites ont été écartés. Ceci maximise l’équité des comparaisons directes et élimine la subjectivité de la vérité de référence.
ensemble de test QA
- 20 000 passages en anglais (10 000 conformes et 10 000 non conformes) rédigés indépendamment par le service d’assurance qualité.
- Longueur minimale de 10 caractères ; sinon, même échantillonnage, étiquetage, provenance de la licence, règle définitive à 100 % et protocole de catégorie que l’ensemble DS
L'ensemble de données scientifiques a été strictement exclu des corpus originaux utilisés pour l'entraînement. L'ensemble de questions-réponses comprend des passages intentionnellement rédigés après l'entraînement du modèle ; ces textes n'ont jamais été utilisés lors de l'entraînement et ne proviennent pas des corpus d'entraînement.
2. Détails de la chaîne d'outils et de l'exécution
- API Copyleaks v1, interrogée le 24 juin 2025
- Points d'accès concurrents (interrogés avec un prétraitement identique le 24 juin 2025)
- OpenAI Moderation v2, seuil par défaut
- Azure AI Content Safety, version 2025-06-15
- API Google Perspective rév. 2025-06-12, seuil de toxicité = 0,50
- Prétraitement : préservation des émojis, pas de lemmatisation ni de mise en minuscules
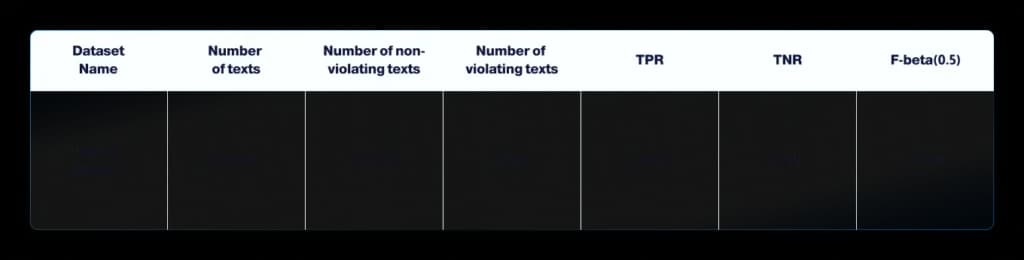
- Pour chaque exécution, nous avons enregistré la réponse JSON brute, dérivé un verdict binaire, construit une matrice de confusion (TP, FP, TN, FN) puis calculé l'exactitude, la précision, le rappel, le TNR et le F-Beta(0,5).
Définition des catégories de modération
Les définitions suivantes ont été utilisées pour les catégories de modération :
- Contenu adulte : Descriptions, références ou représentations explicites d'actes ou de comportements sexuels destinés à susciter l'excitation sexuelle.
- Toxique : Langage blessant qui insulte, dénigre ou rabaisse de manière générale, sans nécessairement viser une personne en particulier. Cela inclut tout langage destiné à causer un préjudice émotionnel.
- Violent : Langage qui incite à la violence physique ou qui la glorifie.
- Langage grossier : Utilisation de jurons forts ou offensants.
- Automutilation : Références qui encouragent ou normalisent les comportements d'automutilation.
- Harcèlement : Abus ciblé qui insulte ou dégrade une personne ou un groupe spécifique, en se concentrant sur des traits personnels ou des croyances.
- Discours de haine : Langage qui diabolise ou incite à la violence envers un groupe ou un individu en raison de caractéristiques inhérentes, appelant souvent à la violence ou à la discrimination systémique.
- Usage de drogues : Références, descriptions ou approbations de l'usage, de l'abus ou de la distribution de drogues dans un contexte nocif, y compris les substances illégales ou le mésusage de médicaments légaux.
- Armes à feu : Tout contenu abordant l'utilisation, la possession ou la distribution d'armes à feu et autres armes, en particulier lorsque de telles discussions pourraient promouvoir ou provoquer des actes de violence ou des pratiques dangereuses.
- Cybersécurité : Contenu relatif à la sécurité informatique, y compris des discussions sur le piratage, les violations de données et les mesures visant à pirater les systèmes numériques ou à obtenir un accès non autorisé.
- Autres : Tout autre contenu jugé inapproprié, nuisible ou offensant et non couvert par les catégories ci-dessus.
Définitions des indicateurs
Les indicateurs utilisés dans cette tâche de modération de texte sont les suivants :
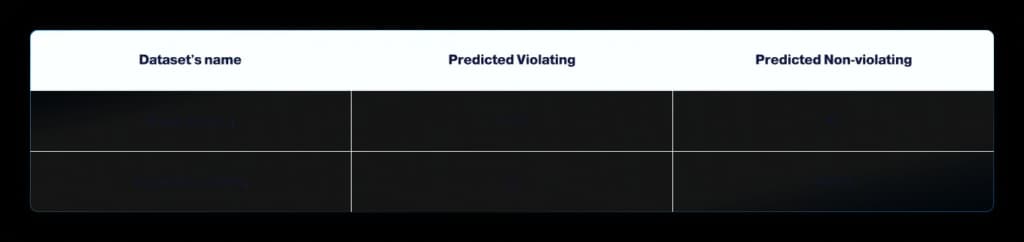
1. Matrice de confusion : Tableau récapitulant les performances du modèle, affichant :
- Vrais positifs (VP) : Textes enfreignant la loi correctement identifiés comme nécessitant une modération.
- Faux positifs (FP) : Textes non enfreignants identifiés à tort comme nécessitant une modération.
- True Negatives (TN) : Textes non enfreignants correctement identifiés comme ne nécessitant pas de modération.
- Faux négatifs (FN) : Textes enfreignant les règles identifiés à tort comme ne nécessitant pas de modération.
2. Exactitude : La proportion d'instances correctement classées (vrais positifs et vrais négatifs) sur le nombre total de textes évalués.
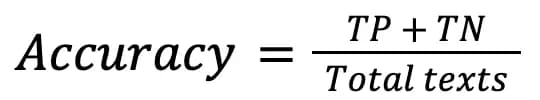
3. Taux de vrais négatifs (TVN) : Proportion d’instances négatives correctement identifiées comme telles. Dans le contexte de la modération de texte, le TVN mesure la performance du modèle sur les textes non enfreignants.
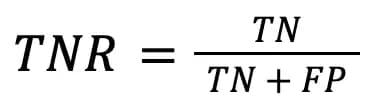
4. Taux de vrais positifs (TVP) / Rappel : Proportion d’instances positives correctement identifiées comme telles. Dans le contexte de la modération de texte, le TVP mesure la performance du modèle face aux textes non conformes.
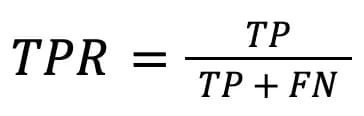
5. Précision : Proportion d’observations positives correctement prédites parmi toutes les prédictions positives. Dans le contexte de la modération de texte, la précision mesure la fiabilité du modèle lorsqu’il signale un contenu ; elle indique combien de textes identifiés comme non conformes par le modèle ont effectivement été modérés.
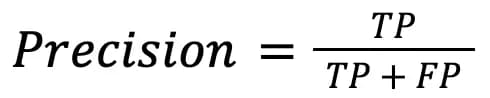
6. Score F-bêta : Moyenne harmonique pondérée de la précision et du rappel, où le paramètre bêta est paramétré pour privilégier la précision. Cette priorisation contribue à réduire le taux de faux positifs.
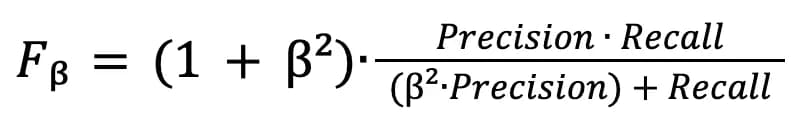
Résultats
Équipe de science des données
Matrice de confusion
équipe d'assurance qualité
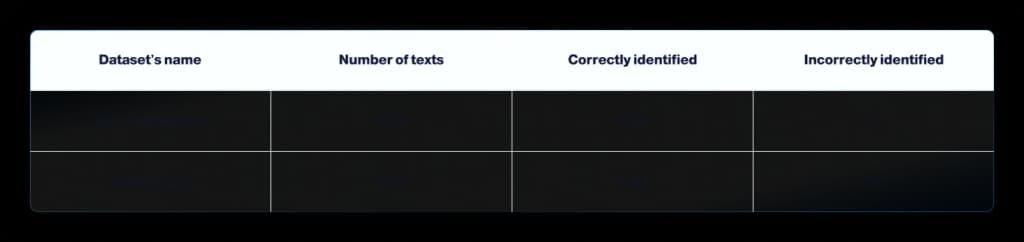
Résumé des indicateurs de test QA :
Précision globale : 0,9923
Précision : 0,9997
Rappel : 0,9848
F-beta (β = 0,5) : 0,9967
Comparaison directe
Limites
- Champ d'application linguistique : ce modèle et son évaluation ne couvrent que l'anglais.
- Portée du contexte : la modération s’effectue sur un seul passage à la fois, un passage étant un segment de texte autonome comportant un certain nombre d’éléments. Le système ne conserve aucune trace des passages, chapitres ou échanges entre les dialogues ; par conséquent, des références telles que « comme nous l’avons expliqué précédemment » ou des pronoms dépendant du contexte antérieur peuvent être omis.
- Champ d'application des modalités : ce produit évalue uniquement le texte ; aucune image, aucun fichier audio ni aucune vidéo n'ont été inclus.