Evaluación de la precisión de la moderación de textos de Copyleaks
Una metodología detallada
Consideramos fundamental ser totalmente transparentes sobre la precisión de nuestro modelo de moderación de texto, las tasas de falsos positivos y falsos negativos, las áreas de mejora y otros aspectos para garantizar un uso y una adopción responsables. Este análisis exhaustivo tiene como objetivo asegurar la total transparencia en torno a la metodología de prueba de nuestro modelo de moderación de texto.
Resumen ejecutivo
El modelo de moderación de texto Copyleaks v1 fue sometido a una evaluación ciega por dos equipos sobre un total de 120.000 textos en inglés (50 % que infringían las normas y 50 % que no las infringían) que fueron completamente separados del conjunto de datos de entrenamiento.
La evaluación demuestra que el modelo puede identificar contenido dañino con una precisión muy alta, mientras que casi nunca señala texto inocente.
Cuando se procesó el mismo conjunto de datos a través de tres de las principales API de moderación comerciales (OpenAI, Azure y Google) con sus umbrales predeterminados, Copyleaks produjo menos falsos positivos y falsos negativos, con una ventaja del 4 % al 30 % en las métricas clave.
Cifras clave (conjunto de prueba de control de calidad, N = 20 000)
- Precisión: 99,23 %
- Precisión: 99,97 % (3 falsos positivos en 10.000 textos que no infringen las normas)
- Recuperación (TPR): 98,48 %
- Puntuación F-Beta(0,5): 99,67 %
Metodología
Se llevó a cabo una evaluación a ciegas por parte de dos equipos para obtener una visión imparcial del rendimiento del modelo. Los equipos de Ciencia de Datos y Control de Calidad trabajaron de forma totalmente aislada, utilizando máquinas y scripts diferentes, sin compartir datos.
1. Construcción de conjuntos de pruebas
Conjunto de pruebas de ciencia de datos
- 100.000 pasajes en inglés (50.000 que no infringen las normas / 50.000 que sí las infringen)
- Textos muestreados aleatoriamente sin reemplazo de cuatro fuentes verificadas: filtraciones públicas de redes sociales, artículos de noticias, literatura de dominio público y casos excepcionales generados por Copyleaks. Todo el material es de dominio público o se utiliza bajo licencias explícitas.
- Verificación cruzada con dos LLM externos; solo se conservan los elementos unánimes.
- Cobertura en todas las categorías de pólizas de Copyleaks.
- Filtro de certeza de etiquetas: solo se conservaron los pasajes cuyo estado de moderación era 100% definitivo; se descartaron los textos dudosos. Esto maximiza la imparcialidad en las comparaciones directas y elimina la subjetividad de la verdad fundamental.
Conjunto de pruebas de control de calidad
- 20.000 pasajes en inglés (10.000 que no infringen las normas / 10.000 que sí las infringen) elaborados de forma independiente por el departamento de control de calidad.
- Longitud mínima de 10 caracteres; por lo demás, se aplican el mismo muestreo, etiquetado, procedencia de la licencia, regla definitiva del 100 % y protocolo de categoría que el conjunto DS.
El conjunto de datos para ciencia de datos se excluyó estrictamente de los corpus originales utilizados para el entrenamiento. El conjunto de preguntas y respuestas comprende pasajes creados intencionalmente después del entrenamiento del modelo; estos textos nunca se vieron durante el entrenamiento y no se extrajeron de los corpus de entrenamiento.
2. Detalles de la cadena de herramientas y la ejecución.
- API Copyleaks v1, consultada el 24 de junio de 2025.
- Puntos finales de la competencia (consultados con el mismo preprocesamiento el 24 de junio de 2025)
- Moderación de OpenAI v2, umbral predeterminado
- Azure AI Content Safety compilación 2025-06-15
- API de Google Perspective, revisión 2025-06-12, umbral de toxicidad = 0,50
- Preprocesamiento: conservación de emojis, sin reducción de raíz ni conversión a minúsculas.
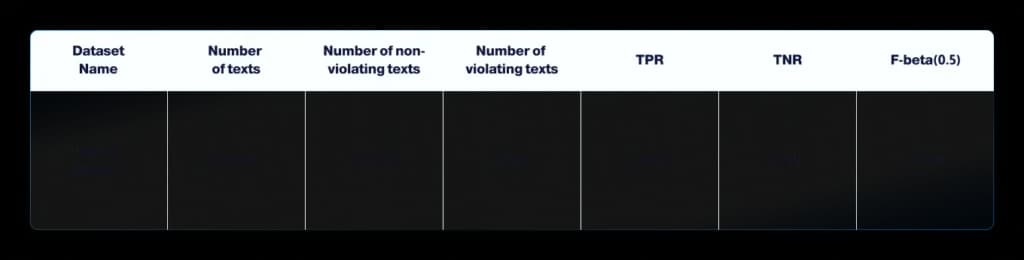
- Para cada ejecución registramos la respuesta JSON sin procesar, derivamos un veredicto binario, construimos una matriz de confusión (TP, FP, TN, FN) y luego calculamos la precisión, exactitud, exhaustividad, TNR y F-Beta(0.5).
Definición de categorías de moderación
Para las categorías de moderación se utilizaron las siguientes definiciones:
- Adultos : Descripciones, referencias o representaciones explícitas de actos o comportamientos sexuales destinadas a provocar excitación sexual.
- Tóxico : Lenguaje dañino que insulta, humilla o degrada de forma general, no necesariamente dirigido a una persona específica. Esto incluye cualquier lenguaje que pretenda causar daño emocional.
- Violento : Lenguaje que incita o glorifica el daño físico o las lesiones.
- Lenguaje soez : Uso de palabrotas fuertes u ofensivas.
- Autolesión : Referencias que fomentan o normalizan el comportamiento autolesivo.
- Acoso : Abuso dirigido que insulta o degrada a una persona o grupo específico, centrándose en rasgos o creencias personales.
- Discurso de odio : Lenguaje que demoniza o incita al daño contra un grupo o individuo basándose en rasgos inherentes, a menudo incitando a la violencia o a la discriminación sistémica.
- Uso de drogas : Referencias, descripciones o avales del uso, abuso o distribución de drogas en un contexto perjudicial, incluidas las sustancias ilegales o el uso indebido de medicamentos legales.
- Armas de fuego : Contenido que trate sobre el uso, la posesión o la distribución de armas de fuego y otras armas, especialmente cuando dichas discusiones puedan promover o causar violencia o prácticas inseguras.
- Ciberseguridad : Contenido relacionado con la seguridad informática, incluyendo debates sobre piratería informática, filtraciones de datos y medidas para piratear sistemas digitales u obtener acceso no autorizado.
- Otros : Cualquier otro contenido que se considere inapropiado, dañino u ofensivo y que no esté contemplado en las categorías anteriores.
Definiciones de métricas
Las métricas que se utilizan en esta tarea de moderación de texto son:
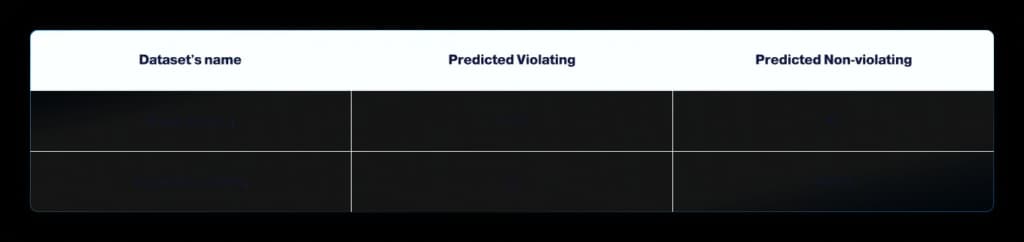
1. Matriz de confusión : Una tabla que resume el rendimiento del modelo, mostrando:
- Verdaderos Positivos (TP) : Textos que infringen las normas y que han sido identificados correctamente como necesitados de moderación.
- Falsos positivos (FP) : Textos que no infringen las normas se identifican erróneamente como textos que necesitan moderación.
- Verdaderos negativos (TN) : Textos que no infringen las normas y que fueron identificados correctamente como que no necesitan moderación.
- Falsos negativos (FN) : Textos que infringen las normas y que fueron identificados erróneamente como que no necesitaban moderación.
2. Precisión : La proporción de instancias clasificadas correctamente (tanto verdaderos positivos como verdaderos negativos) respecto del número total de textos evaluados.
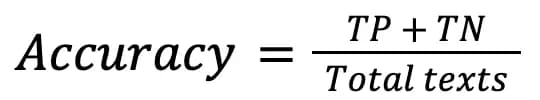
3. Tasa de Verdaderos Negativos (TNR) : La proporción de instancias negativas reales que se identifican correctamente como tales. En el contexto de la moderación de texto, la TNR mide el rendimiento del modelo en textos que no infringen las normas.
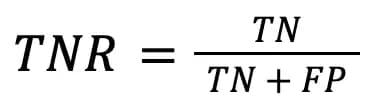
4. Tasa de verdaderos positivos (TPR) / Recuperación : La proporción de instancias positivas reales que se identifican correctamente como positivas. En el contexto de la moderación de texto, la TPR mide el rendimiento del modelo en textos que infringen las normas.
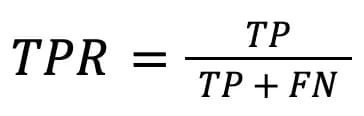
5. Precisión : La proporción de observaciones positivas predichas correctamente respecto al total de predicciones positivas. En el contexto de la moderación de textos, la precisión mide la fiabilidad del modelo al marcar contenido; nos indica cuántos de los textos identificados como infractores por el modelo fueron realmente moderados.
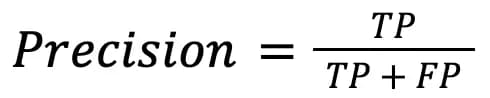
6. Puntuación F-beta : Media armónica ponderada de precisión y exhaustividad, donde el parámetro beta se ajusta para favorecer la precisión. Esta priorización ayuda a lograr una menor tasa de falsos positivos.
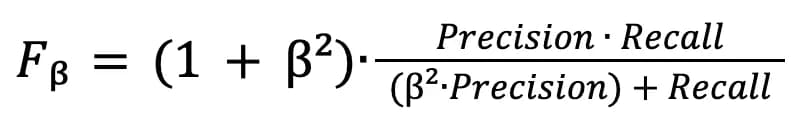
Resultados
Equipo de Ciencia de Datos
Matriz de confusión
equipo de control de calidad
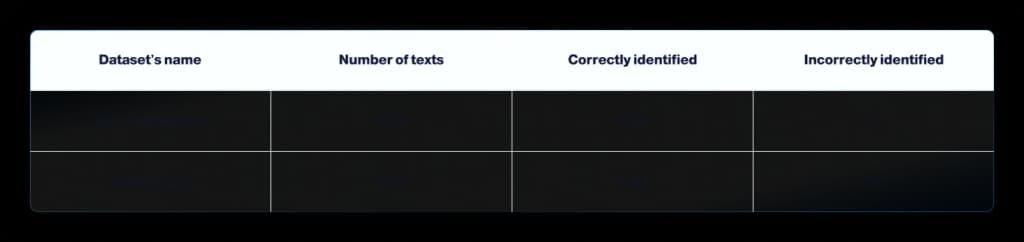
Resumen de las métricas de las pruebas de control de calidad:
Precisión general : 0,9923
Precisión : 0,9997
Recuperación : 0,9848
F-beta (β = 0,5) : 0,9967
Comparativa directa
Limitaciones
- Ámbito lingüístico: este modelo y su evaluación abarcan únicamente el inglés.
- Ámbito del contexto: la moderación se realiza sobre un único «pasaje» a la vez, donde un pasaje es un fragmento de texto independiente con un número determinado de tokens. El sistema no guarda memoria entre pasajes, capítulos o turnos de conversación; por lo tanto, es posible que se omitan referencias como «como explicamos anteriormente» o pronombres que dependen del contexto previo.
- Alcance de la modalidad: este producto analiza únicamente texto; no se incluyeron entradas de imagen, audio o vídeo.