Оценка точности модерации текста Copyleaks
Подробная методология
Мы считаем крайне важным обеспечить полную прозрачность в отношении точности нашей модели модерации текста, количества ложных срабатываний и ложных отрицаний, областей для улучшения и многого другого, чтобы гарантировать ответственное использование и внедрение. Этот всесторонний анализ призван обеспечить полную прозрачность в отношении методологии тестирования нашей модели модерации текста.
Управляющее резюме
Copyleaks Text Moderation Model v1 was subjected to a blind, dual-team evaluation on a total of 120,000 English texts (50% violating, 50% non-violating) that were completely separated from the training dataset.
The assessment shows the model can identify harmful content with very high recall while almost never flagging innocent text.
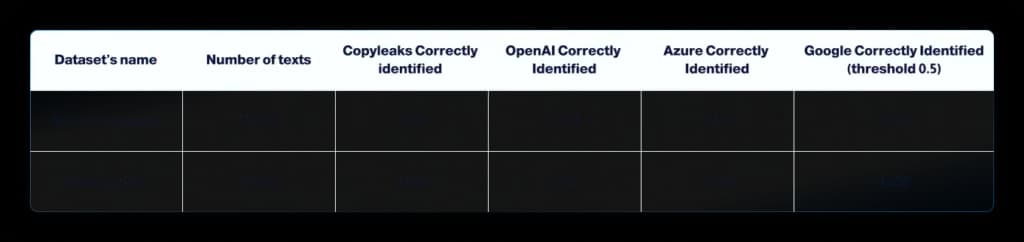
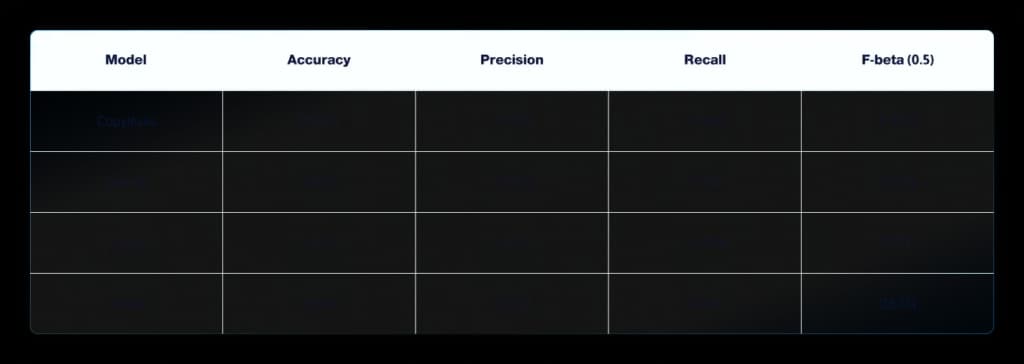
When the identical dataset was processed through three leading commercial moderation APIs (OpenAI, Azure, and Google) at their default thresholds, Copyleaks produced fewer false positives and false negatives, with an advantage of 4%-30% across key metrics.
Key figures (QA test set, N = 20,000)
- Accuracy: 99.23 %
- Precision: 99.97 % (3 false positives in 10,000 non-violating texts)
- Recall (TPR): 98.48 %
- F-Beta(0.5) score: 99.67 %
Методология
Для получения объективной картины производительности модели была проведена слепая оценка двумя командами. Команды специалистов по анализу данных и контролю качества работали в полной изоляции, используя разные компьютеры, разные скрипты и не обмениваясь данными.
1. Построение тестовых наборов
Набор тестов для анализа данных
- 100 000 отрывков на английском языке (50 000 не нарушающих правила / 50 000 нарушающих)
- Тексты были отобраны случайным образом без повторений из четырех проверенных источников: общедоступных архивов в социальных сетях, новостных статей, общедоступной литературы и примеров, сгенерированных Copyleaks. Все материалы либо находятся в общественном достоянии, либо используются на основании явно выраженных лицензий.
- Проверяем данные у двух внешних экспертов в области управления обучением; учитываются только единогласные мнения.
- Покрытие распространяется на все категории полисов Copyleaks.
- Фильтр достоверности меток: сохранялись только те фрагменты, чей статус модерации был однозначно положительным (100%); любые тексты, находящиеся на грани допустимого, отбрасывались. Это обеспечивает максимальную справедливость при прямом сравнении и исключает субъективность из объективной картины.
Набор тестов контроля качества
- 20 000 отрывков на английском языке (10 000 без нарушений / 10 000 с нарушениями), независимо подготовленных отделом контроля качества.
- Минимальная длина — 10 символов; в остальном — те же параметры выборки, маркировки, происхождения лицензии, правило 100% достоверности и протокол классификации, что и в наборе DS.
Набор данных для анализа данных был строго исключен из исходного корпуса, использованного для обучения. Набор вопросов и ответов включает в себя фрагменты, специально созданные после обучения модели; эти тексты никогда не использовались во время обучения и не были взяты из обучающего корпуса.
2. Инструментарий и детали выполнения.
- Copyleaks API v1, queried 24 June 2025
- Competitor endpoints (queried with identical pre-processing on 24 June 2025)
- OpenAI Moderation v2, default threshold
- Azure AI Content Safety build 2025-06-15
- Google Perspective API rev. 2025-06-12, toxicity threshold = 0.50
- Pre-processing: emoji preservation, no stemming or lower-casing
- For each run we recorded the raw JSON response, derived a binary verdict, built a confusion matrix (TP, FP, TN, FN) and then computed Accuracy, Precision, Recall, TNR, and F-Beta(0.5)
Определение категорий модерации
Для категорий модерации использовались следующие определения:
- Для взрослых : Откровенные описания, упоминания или изображения сексуальных действий или поведения, призванные вызвать сексуальное возбуждение.
- Токсичное высказывание : оскорбительные, унижающие или деградирующие высказывания в общем смысле, не обязательно направленные на конкретного человека. Сюда входит любое высказывание, направленное на причинение эмоционального вреда.
- Жестокий : Язык, который подстрекает или прославляет физический вред или увечья.
- Ненормативная лексика : использование сильных или оскорбительных ругательств.
- Самоповреждение : Упоминания, которые поощряют или нормализуют самоповреждающее поведение.
- Преследование : Целенаправленное оскорбление или унижение конкретного человека или группы лиц, направленное на личные качества или убеждения.
- Язык ненависти : высказывания, которые демонизируют или подстрекают к причинению вреда группе или отдельному человеку на основе присущих им черт, часто призывая к насилию или системной дискриминации.
- Употребление наркотиков : Упоминания, описания или одобрение употребления, злоупотребления или распространения наркотиков в опасном контексте, включая незаконные вещества или неправильное использование легальных наркотиков.
- Огнестрельное оружие : Контент, обсуждающий использование, владение или распространение огнестрельного и другого оружия, особенно если такие обсуждения могут способствовать насилию или небезопасным действиям.
- Кибербезопасность : Материалы, связанные с компьютерной безопасностью, включая обсуждение взлома, утечек данных и мер по взлому цифровых систем или получению несанкционированного доступа.
- Прочее : любой другой контент, считающийся неприемлемым, вредным или оскорбительным, не подпадающий под вышеуказанные категории.
Определения метрик
В этой задаче модерации текста используются следующие метрики:
1. Матрица ошибок : Таблица, суммирующая результаты работы модели и отображающая:
- Истинные положительные результаты (ИП) : Тексты, нарушающие правила, правильно идентифицированные как нуждающиеся в модерации.
- Ложные срабатывания (ЛС) : Тексты, не нарушающие правила, ошибочно идентифицированы как нуждающиеся в модерации.
- Истинные отрицания (TN) : Тексты, не нарушающие правила, правильно идентифицированные как не требующие модерации.
- Ложные отрицания (FN) : Тексты, нарушающие правила, ошибочно помеченные как не требующие модерации.
2. Точность : Доля правильно классифицированных случаев (как истинно положительных, так и истинно отрицательных) от общего числа оцененных текстов.
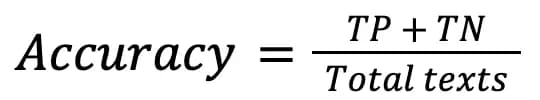
3. Показатель истинно отрицательных результатов (TNR) : доля фактически отрицательных случаев, которые правильно идентифицированы как отрицательные. В контексте модерации текста TNR измеряет эффективность модели при работе с текстами, не нарушающими правила.
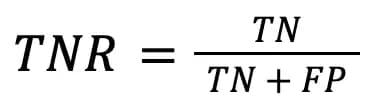
4. Показатель истинно положительных результатов (TPR) / полнота : доля действительно положительных случаев, которые были правильно идентифицированы как положительные. В контексте модерации текста TPR измеряет эффективность модели при работе с текстами, нарушающими правила.
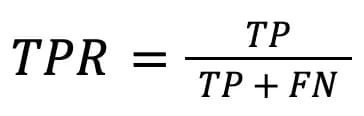
5. Точность : Доля правильно предсказанных положительных результатов из всех положительных предсказаний. В контексте модерации текста точность измеряет надежность модели при выявлении контента, нарушающего правила; она показывает, сколько текстов, идентифицированных моделью как нарушающие правила, действительно были модерированы.
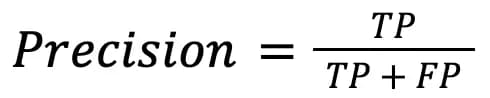
6. Показатель F-бета : Взвешенное гармоническое среднее точности и полноты, где параметр бета устанавливается в пользу точности. Такая приоритезация помогает добиться более низкого уровня ложноположительных результатов.
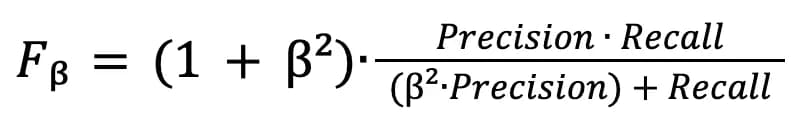
Результаты
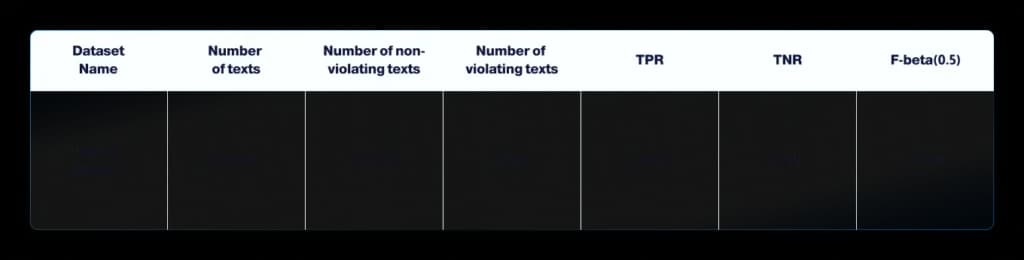
Команда специалистов по анализу данных
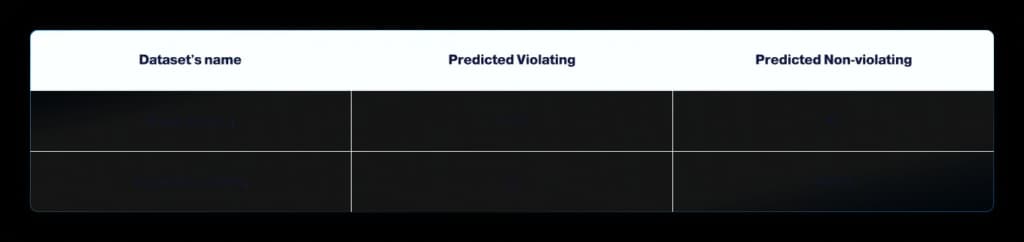
Матрица ошибок
команда контроля качества
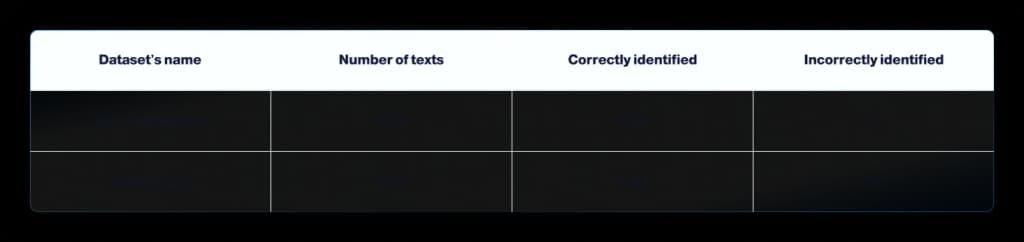
Сводка метрик тестирования качества:
Общая точность : 0,9923
Точность : 0,9997
Полнота : 0,9848
F-бета (β = 0,5) : 0,9967
Сравнительный тест
Ограничения
- Языковая область: данная модель и ее оценка охватывают только английский язык.
- Область действия контекста: модерация осуществляется для одного «фрагмента» за раз, где фрагмент представляет собой самодостаточный блок текста с определенным количеством токенов. Система не сохраняет память между фрагментами, главами или репликами в разговоре; поэтому ссылки, такие как «как мы объяснили ранее», или местоимения, зависящие от предыдущего контекста, могут быть пропущены.
- Область применения: данный продукт оценивает только текст; изображения, аудио или видео не включены.