تقييم دقة عملية مراجعة النصوص المسربة
منهجية مفصلة
نؤمن بأهمية الشفافية الكاملة فيما يتعلق بدقة نموذجنا لمراقبة النصوص، ومعدلات الإنذارات الكاذبة والإنذارات الكاذبة، ومجالات التحسين، وغير ذلك، لضمان الاستخدام المسؤول والتبني الأمثل. يهدف هذا التحليل الشامل إلى ضمان الشفافية الكاملة حول منهجية اختبار نموذجنا لمراقبة النصوص.
ملخص تنفيذي
تم إخضاع نموذج Copyleaks Text Moderation Model v1 لتقييم ثنائي الفريق أعمى على ما مجموعه 120,000 نص إنجليزي (50٪ منتهك، 50٪ غير منتهك) تم فصلها تمامًا عن مجموعة بيانات التدريب.
يُظهر التقييم أن النموذج قادر على تحديد المحتوى الضار بدقة عالية جدًا، بينما نادرًا ما يُشير إلى النصوص البريئة.
عندما تمت معالجة مجموعة البيانات المتطابقة من خلال ثلاث واجهات برمجة تطبيقات تجارية رائدة في مجال الإشراف (OpenAI وAzure وGoogle) عند عتباتها الافتراضية، أنتجت Copyleaks عددًا أقل من النتائج الإيجابية الخاطئة والنتائج السلبية الخاطئة، مع ميزة تتراوح بين 4% و30% عبر المقاييس الرئيسية.
الأرقام الرئيسية (مجموعة اختبار ضمان الجودة، N = 20000)
- الدقة: 99.23%
- الدقة: 99.97% (3 نتائج إيجابية خاطئة في 10000 نص غير مخالف)
- نسبة الاستدعاء (TPR): 98.48%
- قيمة F-Beta(0.5): 99.67%
المنهجية
أُجري تقييم ثنائي الفريق، دون معرفة مسبقة بالنتائج، للحصول على صورة موضوعية لأداء النموذج. عمل فريقا علوم البيانات وضمان الجودة بشكل منفصل تمامًا، باستخدام أجهزة وبرامج نصية مختلفة، ودون أي بيانات مشتركة.
1. بناء مجموعات الاختبار
مجموعة اختبار علوم البيانات
- 100,000 مقطع باللغة الإنجليزية (50,000 غير مخالفة / 50,000 مخالفة)
- تم اختيار النصوص عشوائياً دون استبدال من أربعة مصادر موثوقة: منشورات وسائل التواصل الاجتماعي العامة، والمقالات الإخبارية، والأدبيات المتاحة للعموم، وحالات استثنائية تم إنشاؤها بواسطة Copyleaks. جميع المواد إما متاحة للعموم أو مستخدمة بموجب تراخيص صريحة.
- التحقق المتبادل مع مرجعين خارجيين للتعلم الآلي؛ يتم الاحتفاظ فقط بالبنود التي تم الاتفاق عليها بالإجماع
- تغطية شاملة لجميع فئات وثائق التأمين ضد تسريبات النسخ
- فلتر اليقين في التصنيف: تم الاحتفاظ فقط بالمقاطع التي كانت حالة مراجعتها نهائية بنسبة 100%؛ وتم استبعاد أي نصوص مشكوك في صحتها. هذا يضمن أقصى قدر من العدالة في المقارنات المباشرة ويزيل الذاتية من الحقيقة المطلقة.
مجموعة اختبار ضمان الجودة
- 20,000 مقطعًا باللغة الإنجليزية (10,000 غير مخالفة / 10,000 مخالفة) تمت صياغتها بشكل مستقل من قبل قسم ضمان الجودة
- الحد الأدنى للطول 10 أحرف؛ وإلا فإن نفس إجراءات أخذ العينات، والتصنيف، ومصدر الترخيص، وقاعدة التحديد بنسبة 100%، وبروتوكول الفئة كما هو الحال في مجموعة DS
تم استبعاد مجموعة بيانات علوم البيانات بشكل قاطع من مجموعات النصوص الأصلية المستخدمة في التدريب. أما مجموعة الأسئلة والأجوبة فتتألف من مقاطع كُتبت عمداً بعد تدريب النموذج؛ ولم تُشاهد هذه النصوص أثناء التدريب ولم تُستخرج من مجموعات نصوص التدريب.
2. سلسلة الأدوات وتفاصيل التنفيذ
- واجهة برمجة تطبيقات Copyleaks الإصدار 1، تم الاستعلام عنها في 24 يونيو 2025
- نقاط نهاية المنافسين (تم الاستعلام عنها بمعالجة مسبقة متطابقة في 24 يونيو 2025)
- OpenAI Moderation v2، العتبة الافتراضية
- إصدار Azure AI Content Safety بتاريخ 15 يونيو 2025
- واجهة برمجة تطبيقات Google Perspective، الإصدار 2025-06-12، عتبة السمية = 0.50
- المعالجة المسبقة: الحفاظ على الرموز التعبيرية، وعدم استخدام الأحرف الصغيرة أو تحويلها إلى حروف أصلية.
- لكل عملية تشغيل قمنا بتسجيل استجابة JSON الخام، واستخلصنا حكمًا ثنائيًا، وقمنا ببناء مصفوفة الارتباك (TP، FP، TN، FN) ثم قمنا بحساب الدقة، والدقة، والاستدعاء، وTNR، وF-Beta(0.5).
تعريف فئات الإشراف
تم استخدام التعريفات التالية لفئات الاعتدال:
- للبالغين : أوصاف أو إشارات أو تصويرات صريحة لأفعال أو سلوكيات جنسية تهدف إلى إثارة الشهوة الجنسية.
- سام : لغة مؤذية تُهين أو تُحط من قدر شخص ما أو تُحط من قدره بشكل عام، وليس بالضرورة موجهة لشخص معين. ويشمل ذلك أي لغة تهدف إلى إلحاق الأذى النفسي.
- عنيف : لغة تحرض على الأذى الجسدي أو الإصابة أو تمجدها.
- الألفاظ النابية : استخدام كلمات بذيئة قوية أو مسيئة.
- إيذاء النفس : إشارات تشجع أو تجعل السلوك المؤذي للنفس أمراً طبيعياً.
- التحرش : إساءة موجهة تهين أو تحط من قدر شخص أو مجموعة معينة، مع التركيز على السمات الشخصية أو المعتقدات.
- خطاب الكراهية : لغة تشوه صورة مجموعة أو فرد أو تحرض على إلحاق الأذى بهما بناءً على سمات متأصلة، وغالباً ما تدعو إلى العنف أو التمييز المنهجي.
- استخدام المخدرات : الإشارات أو الأوصاف أو التأييدات لاستخدام المخدرات أو إساءة استخدامها أو توزيعها في سياق ضار، بما في ذلك المواد غير المشروعة أو إساءة استخدام الأدوية القانونية.
- الأسلحة النارية : المحتوى الذي يناقش استخدام أو حيازة أو توزيع الأسلحة النارية وغيرها من الأسلحة، وخاصة عندما يمكن أن تؤدي هذه المناقشات إلى تعزيز أو التسبب في العنف أو الممارسات غير الآمنة.
- الأمن السيبراني : محتوى متعلق بأمن الحاسوب، بما في ذلك مناقشات حول القرصنة، وانتهاكات البيانات، وتدابير اختراق الأنظمة الرقمية أو الحصول على وصول غير مصرح به.
- أخرى : أي محتوى آخر يعتبر غير لائق أو ضار أو مسيء ولا يشمله التصنيف المذكور أعلاه.
تعريفات المقاييس
المقاييس المستخدمة في مهمة الإشراف على النصوص هذه هي:
1. مصفوفة الارتباك : جدول يلخص أداء النموذج، ويعرض ما يلي:
- الإيجابيات الحقيقية (TP) : النصوص المخالفة التي تم تحديدها بشكل صحيح على أنها بحاجة إلى مراجعة.
- النتائج الإيجابية الخاطئة (FP) : نصوص غير مخالفة تم تحديدها بشكل خاطئ على أنها بحاجة إلى مراجعة.
- النتائج السلبية الصحيحة (TN) : النصوص غير المخالفة التي تم تحديدها بشكل صحيح على أنها لا تحتاج إلى مراجعة.
- النتائج السلبية الخاطئة (FN) : النصوص المخالفة التي تم تحديدها بشكل خاطئ على أنها لا تحتاج إلى مراجعة.
2. الدقة : نسبة الحالات المصنفة بشكل صحيح (الإيجابيات الحقيقية والسلبيات الحقيقية) من إجمالي عدد النصوص التي تم تقييمها.
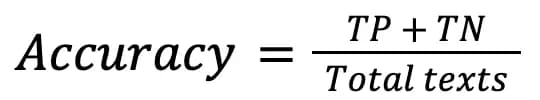
3. معدل النتائج السلبية الصحيحة (TNR) : نسبة الحالات السلبية الفعلية التي تم تحديدها بشكل صحيح على أنها سلبية. في سياق مراقبة النصوص، يقيس معدل النتائج السلبية الصحيحة أداء النموذج في التعامل مع النصوص غير المخالفة.
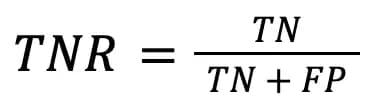
4. معدل الإيجابية الحقيقية (TPR) / الاستدعاء : نسبة الحالات الإيجابية الفعلية التي تم تحديدها بشكل صحيح على أنها إيجابية. في سياق مراقبة النصوص، يقيس معدل الإيجابية الحقيقية أداء النموذج في التعامل مع النصوص المخالفة.
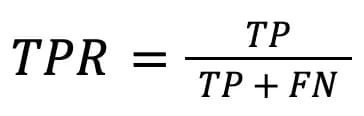
5. الدقة : نسبة الملاحظات الإيجابية المتوقعة بشكل صحيح من إجمالي التوقعات الإيجابية. في سياق مراقبة النصوص، تقيس الدقة موثوقية النموذج عند رصده للمحتوى؛ فهي تُبيّن لنا عدد النصوص التي حددها النموذج على أنها مخالفة والتي خضعت بالفعل للمراقبة.
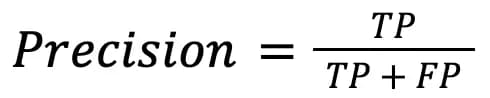
6. مقياس F-beta : هو متوسط توافقي مرجح للدقة والاستدعاء، حيث يتم ضبط معامل بيتا لصالح الدقة. تساعد هذه الأولوية في تحقيق معدل إيجابي خاطئ أقل.
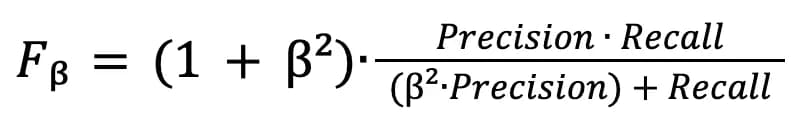
نتائج
فريق علوم البيانات
مصفوفة الارتباك
فريق ضمان الجودة
ملخص مقاييس اختبار ضمان الجودة:
الدقة الإجمالية : 0.9923
الدقة : 0.9997
الاستدعاء : 0.9848
F-beta (β = 0.5) : 0.9967
معيار المواجهة المباشرة
القيود
- نطاق اللغة: يغطي هذا النموذج وتقييمه اللغة الإنجليزية فقط.
- نطاق السياق: تتم عملية المراجعة على "مقطع" واحد في كل مرة، حيث يُعرَّف المقطع بأنه جزء نصي مستقل يحتوي على عدد محدد من الكلمات. لا يحتفظ النظام بأي ذاكرة عبر المقاطع أو الفصول أو أدوار المحادثة؛ لذا قد تُفقد إشارات مثل "كما أوضحنا سابقًا" أو الضمائر التي تعتمد على سياق سابق.
- نطاق الوسائط: يقوم هذا المنتج بتقييم النصوص فقط؛ ولم يتم تضمين أي مدخلات للصور أو الصوت أو الفيديو.