Bewertung der Genauigkeit der Copyleaks-Textmoderation
Eine detaillierte Methodik
Wir legen größten Wert auf volle Transparenz hinsichtlich der Genauigkeit unseres Textmoderationsmodells, der Raten falsch positiver und falsch negativer Ergebnisse, der Verbesserungspotenziale und weiterer Aspekte, um eine verantwortungsvolle Nutzung und breite Akzeptanz zu gewährleisten. Diese umfassende Analyse zielt darauf ab, die Testmethodik unseres Textmoderationsmodells vollständig transparent darzustellen.
Zusammenfassung
Das Copyleaks Text Moderation Model v1 wurde einer verblindeten, von zwei Teams durchgeführten Evaluierung anhand von insgesamt 120.000 englischen Texten unterzogen (50 % Verstöße, 50 % keine Verstöße), die vollständig vom Trainingsdatensatz getrennt waren.
Die Auswertung zeigt, dass das Modell schädliche Inhalte mit sehr hoher Treffsicherheit identifizieren kann, während harmlose Texte fast nie fälschlicherweise als unschädlich eingestuft werden.
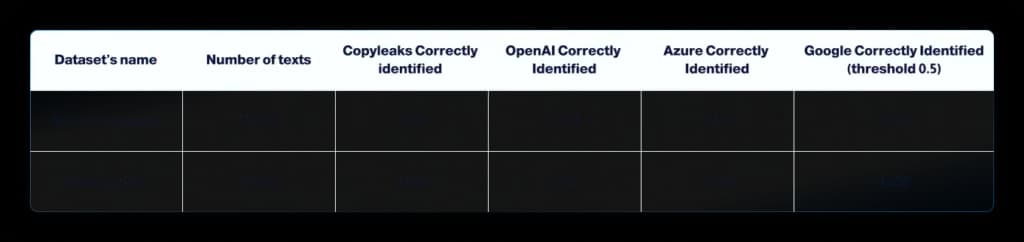
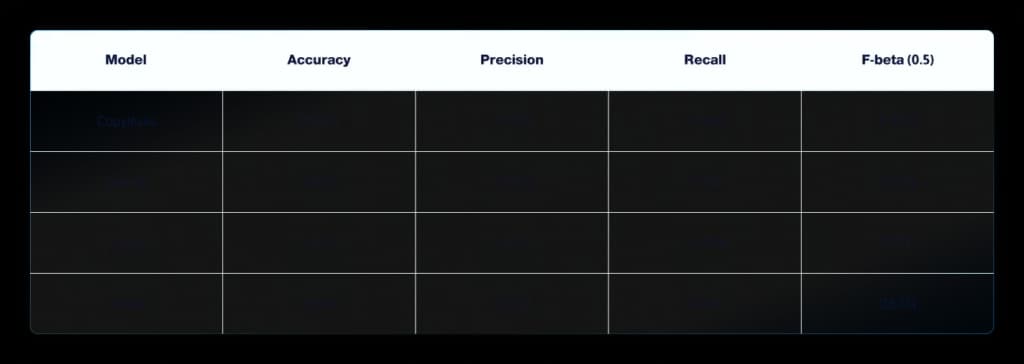
Als der identische Datensatz durch drei führende kommerzielle Moderations-APIs (OpenAI, Azure und Google) mit ihren Standard-Schwellenwerten verarbeitet wurde, erzeugte Copyleaks weniger falsch positive und falsch negative Ergebnisse, mit einem Vorteil von 4 bis 30 % bei allen wichtigen Kennzahlen.
Kennzahlen (QA-Testdatensatz, N = 20.000)
- Genauigkeit: 99,23 %
- Präzision: 99,97 % (3 falsch positive Ergebnisse bei 10.000 nicht verletzenden Texten)
- Rückrufquote (TPR): 98,48 %
- F-Beta(0,5)-Wert: 99,67 %
Methodik
Um ein unvoreingenommenes Bild der Modellleistung zu erhalten, wurde eine verblindete Zweier-Evaluierung durchgeführt. Die Data-Science- und QA-Teams arbeiteten vollständig unabhängig voneinander, d. h. auf unterschiedlichen Rechnern, mit unterschiedlichen Skripten und ohne gemeinsame Daten.
1. Erstellung von Testsets
Data-Science-Testset
- 100.000 englische Textpassagen (50.000 regelkonform / 50.000 regelwidrig)
- Die Texte wurden zufällig und ohne Zurücklegen aus vier geprüften Quellen ausgewählt: öffentlich zugängliche Social-Media-Beiträge, Nachrichtenartikel, gemeinfreie Literatur und von Copyleaks generierte Sonderfälle. Sämtliches Material ist entweder gemeinfrei oder unterliegt ausdrücklichen Lizenzen.
- Gegenprüfung mit zwei externen LLMs; nur übereinstimmende Punkte werden beibehalten.
- Deckung über alle Copyleaks-Versicherungskategorien hinweg
- Filter für eindeutige Moderationsbewertung: Nur Passagen mit 100%ig gesicherter Moderationsbewertung wurden beibehalten; alle Grenzfälle wurden verworfen. Dies maximiert die Fairness bei direkten Vergleichen und beseitigt Subjektivität in der Bewertung.
QA-Testset
- 20.000 englische Textpassagen (10.000 nicht verletzende / 10.000 verletzende), die unabhängig von der Qualitätssicherungsabteilung erstellt wurden
- Mindestlänge von 10 Zeichen; ansonsten gelten die gleichen Protokolle für Probenahme, Kennzeichnung, Lizenzherkunft, 100% endgültige Regelung und Kategorie wie beim DS-Set.
Der Data-Science-Datensatz wurde strikt von den ursprünglichen Trainingskorpora getrennt. Der QA-Datensatz umfasst Passagen, die gezielt nach dem Modelltraining erstellt wurden; diese Texte wurden während des Trainings nie verwendet und stammen nicht aus den Trainingskorpora.
2. Werkzeugkette und Ausführungsdetails
- Copyleaks API v1, abgefragt am 24. Juni 2025
- Endpunkte der Wettbewerber (abgefragt mit identischer Vorverarbeitung am 24. Juni 2025)
- OpenAI Moderation v2, Standardschwellenwert
- Azure AI Content Safety Build 2025-06-15
- Google Perspective API Rev. 2025-06-12, Toxizitätsschwelle = 0,50
- Vorverarbeitung: Emoji-Erhaltung, keine Stammformreduzierung oder Umwandlung in Kleinbuchstaben
- Für jeden Durchlauf haben wir die rohe JSON-Antwort aufgezeichnet, ein binäres Ergebnis abgeleitet, eine Konfusionsmatrix (TP, FP, TN, FN) erstellt und anschließend Genauigkeit, Präzision, Trefferquote, TNR und F-Beta(0,5) berechnet.
Definition der Moderationskategorien
Für die Moderationskategorien wurden folgende Definitionen verwendet:
- Für Erwachsene : Explizite Beschreibungen, Hinweise oder Darstellungen sexueller Handlungen oder Verhaltensweisen, die sexuelle Erregung hervorrufen sollen.
- Toxisch : Schädliche Sprache, die allgemein beleidigt, herabwürdigt oder erniedrigt, ohne sich unbedingt gegen eine bestimmte Person zu richten. Dies umfasst jegliche Sprache, die darauf abzielt, emotionalen Schaden zuzufügen.
- Gewalttätig : Sprache, die zu körperlichem Schaden oder Verletzungen anstiftet oder diese verherrlicht.
- Obszönität : Verwendung von starken oder beleidigenden Schimpfwörtern.
- Selbstverletzung : Verweise, die selbstverletzendes Verhalten fördern oder normalisieren.
- Belästigung : Gezielte Beleidigung oder Herabwürdigung einer bestimmten Person oder Gruppe, wobei der Fokus auf persönlichen Eigenschaften oder Überzeugungen liegt.
- Hassrede : Sprache, die eine Gruppe oder Einzelperson aufgrund ihrer angeborenen Eigenschaften dämonisiert oder zu Gewalt gegen sie aufruft und dabei oft zu systematischer Diskriminierung aufruft.
- Drogenkonsum : Hinweise, Beschreibungen oder Befürwortungen des Gebrauchs, des Missbrauchs oder des Vertriebs von Drogen in einem schädlichen Kontext, einschließlich illegaler Substanzen oder des Missbrauchs legaler Drogen.
- Schusswaffen : Inhalte, die den Gebrauch, den Besitz oder die Verbreitung von Schusswaffen und anderen Waffen thematisieren, insbesondere wenn solche Diskussionen Gewalt oder unsichere Praktiken fördern oder verursachen könnten.
- Cybersicherheit : Inhalte rund um die Computersicherheit, einschließlich Diskussionen über Hacking, Datenlecks und Maßnahmen zum Hacken digitaler Systeme oder zum Erlangen unbefugten Zugriffs.
- Sonstiges : Alle anderen Inhalte, die als unangemessen, schädlich oder anstößig erachtet werden und nicht unter die oben genannten Kategorien fallen.
Metrikdefinitionen
Die in dieser Textmoderationsaufgabe verwendeten Metriken sind:
1. Konfusionsmatrix : Eine Tabelle, die die Leistungsfähigkeit des Modells zusammenfasst und Folgendes anzeigt:
- Richtig Positive (TP) : Zu Recht als moderierungsbedürftig identifizierte, gegen die Regeln verstoßende Texte.
- Falsch-Positive (FP) : Nicht regelwidrige Texte, die fälschlicherweise als moderierungsbedürftig eingestuft wurden.
- Richtig Negativ (TN) : Texte, die keine Verstöße begehen und korrekt als nicht moderierungsbedürftig identifiziert wurden.
- Falsch-Negative (FN) : Verstöße begehende Texte, die fälschlicherweise als nicht moderierungsbedürftig eingestuft wurden.
2. Genauigkeit : Der Anteil der korrekt klassifizierten Fälle (sowohl richtig positive als auch richtig negative) an der Gesamtzahl der ausgewerteten Texte.
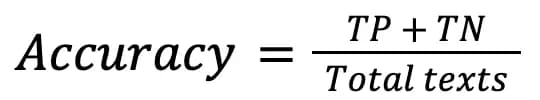
3. Trefferquote (True Negative Rate, TNR) : Der Anteil tatsächlich negativer Fälle, die korrekt als negativ identifiziert werden. Im Kontext der Textmoderation misst die TNR die Leistung des Modells bei nicht regelwidrigen Texten.
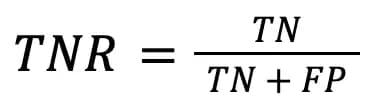
4. Trefferquote (TPR/Recall ): Der Anteil der tatsächlich positiven Fälle, die korrekt als positiv identifiziert werden. Im Kontext der Textmoderation misst die Trefferquote die Leistung des Modells bei Texten, die gegen die Richtlinien verstoßen.
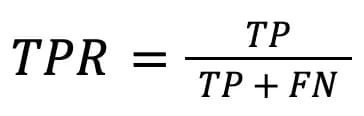
5. Präzision : Der Anteil korrekt vorhergesagter positiver Beobachtungen an allen positiven Vorhersagen. Im Kontext der Textmoderation misst die Präzision die Zuverlässigkeit des Modells bei der Kennzeichnung von Inhalten; sie gibt an, wie viele der vom Modell als regelwidrig identifizierten Texte tatsächlich moderiert wurden.
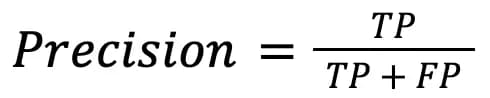
6. F-Beta-Score : Ein gewichtetes harmonisches Mittel aus Präzision und Trefferquote, wobei der Beta-Parameter so eingestellt ist, dass er die Präzision priorisiert. Diese Priorisierung trägt zu einer niedrigeren Falsch-Positiv-Rate bei.
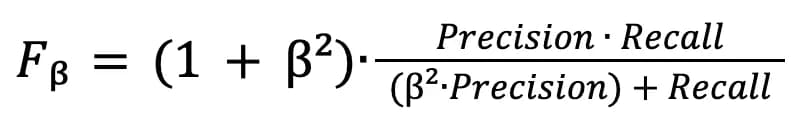
Ergebnisse
Data-Science-Team
Konfusionsmatrix
QA-Team
Zusammenfassung der QA-Testmetriken:
Gesamtgenauigkeit : 0,9923
Präzision : 0,9997
Rückruf : 0,9848
F-Beta (β = 0,5) : 0,9967
Direkter Vergleich
Einschränkungen
- Sprachlicher Geltungsbereich: Dieses Modell und seine Evaluierung beziehen sich ausschließlich auf Englisch.
- Kontextumfang: Die Moderation erfolgt jeweils für einen einzelnen Textabschnitt, wobei ein Textabschnitt ein in sich abgeschlossener Textteil mit einer bestimmten Anzahl von Tokens ist. Das System speichert keine Informationen über Textabschnitte, Kapitel oder Gesprächsbeiträge hinweg; daher können Verweise wie „wie wir bereits erläutert haben“ oder Pronomen, die vom vorherigen Kontext abhängen, übersehen werden.
- Modalitätsbereich: Dieses Produkt bewertet ausschließlich Text; Bild-, Audio- oder Videoeingaben wurden nicht berücksichtigt.