Avaliando a precisão da moderação de texto do Copyleaks
Uma metodologia detalhada
Acreditamos ser de extrema importância sermos totalmente transparentes sobre a precisão do nosso Modelo de Moderação de Texto, as taxas de falsos positivos e falsos negativos, áreas de melhoria e outros aspectos para garantir o uso e a adoção responsáveis. Esta análise abrangente visa assegurar total transparência em relação à metodologia de teste do nosso Modelo de Moderação de Texto.
Sumário executivo
O modelo de moderação de texto Copyleaks v1 foi submetido a uma avaliação cega por duas equipes, em um total de 120.000 textos em inglês (50% violando as regras e 50% não violando), que foram completamente separados do conjunto de dados de treinamento.
A avaliação demonstra que o modelo consegue identificar conteúdo prejudicial com uma taxa de acerto muito alta, enquanto quase nunca sinaliza textos inocentes.
Quando o mesmo conjunto de dados foi processado por meio de três APIs de moderação comerciais líderes (OpenAI, Azure e Google) em seus limites padrão, o Copyleaks produziu menos falsos positivos e falsos negativos, com uma vantagem de 4% a 30% em todas as principais métricas.
Principais indicadores (conjunto de teste de controle de qualidade, N = 20.000)
- Precisão: 99,23%
- Precisão: 99,97% (3 falsos positivos em 10.000 textos que não violam as regras)
- Taxa de recall (TPR): 98,48%
- Pontuação F-Beta(0,5): 99,67%
Metodologia
Foi realizada uma avaliação cega por duas equipes, a fim de obter uma visão imparcial do desempenho do modelo. As equipes de Ciência de Dados e de Garantia da Qualidade trabalharam de forma totalmente isolada, utilizando máquinas diferentes, scripts distintos e sem compartilhamento de dados.
1. Construção de conjuntos de teste
Conjunto de testes de ciência de dados
- 100.000 trechos em inglês (50.000 sem violação / 50.000 com violação)
- Textos selecionados aleatoriamente, sem reposição, a partir de quatro fontes verificadas: vazamentos públicos de mídias sociais, artigos de notícias, literatura de domínio público e casos extremos gerados pelo Copyleaks. Todo o material é de domínio público ou usado sob licenças explícitas.
- Verificação cruzada com dois especialistas externos em direito; apenas os itens unânimes foram mantidos.
- Cobertura em todas as categorias de apólices da Copyleaks
- Filtro de certeza de classificação: apenas as passagens cujo status de moderação era 100% definitivo foram mantidas; quaisquer textos limítrofes foram descartados. Isso maximiza a imparcialidade em comparações diretas e remove a subjetividade da verdade fundamental.
Conjunto de testes de controle de qualidade
- 20.000 trechos em inglês (10.000 sem violações / 10.000 com violações) elaborados independentemente pelo departamento de controle de qualidade.
- Comprimento mínimo de 10 caracteres; caso contrário, a amostragem, a rotulagem, a proveniência da licença, a regra 100% definitiva e o protocolo de categoria são os mesmos do conjunto DS.
O conjunto de dados de Ciência de Dados foi estritamente separado dos corpora originais usados para treinamento. O conjunto de perguntas e respostas (QA) compreende trechos criados intencionalmente após o treinamento do modelo; esses textos nunca foram vistos durante o treinamento e não foram extraídos dos corpora de treinamento.
2. Detalhes da cadeia de ferramentas e da execução
- API Copyleaks v1, consultada em 24 de junho de 2025
- Pontos finais da concorrência (consultados com pré-processamento idêntico em 24 de junho de 2025)
- Moderação OpenAI v2, limite padrão
- Azure AI Content Safety build 2025-06-15
- API Google Perspective rev. 2025-06-12, limite de toxicidade = 0,50
- Pré-processamento: preservação de emojis, sem stemming ou conversão para minúsculas.
- Para cada execução, registramos a resposta JSON bruta, derivamos um veredicto binário, construímos uma matriz de confusão (TP, FP, TN, FN) e então calculamos Acurácia, Precisão, Recall, TNR e F-Beta(0,5)
Definição das categorias de moderação
As seguintes definições foram utilizadas para as categorias de moderação:
- Conteúdo adulto : Descrições, referências ou representações explícitas de atos ou comportamentos sexuais com o intuito de provocar excitação sexual.
- Tóxico : Linguagem prejudicial que insulta, menospreza ou degrada de forma geral, não necessariamente direcionada a uma pessoa específica. Isso inclui qualquer linguagem com a intenção de causar dano emocional.
- Violento : Linguagem que incita ou glorifica danos ou lesões físicas.
- Linguagem obscena : Uso de palavrões fortes ou ofensivos.
- Automutilação : Referências que incentivam ou normalizam o comportamento autolesivo.
- Assédio : Abuso direcionado que insulta ou degrada uma pessoa ou grupo específico, com foco em características ou crenças pessoais.
- Discurso de ódio : Linguagem que demoniza ou incita violência contra um grupo ou indivíduo com base em características inerentes, frequentemente apelando à violência ou à discriminação sistêmica.
- Uso de drogas : Referências, descrições ou endossos ao uso, abuso ou distribuição de drogas em um contexto prejudicial, incluindo substâncias ilegais ou o uso indevido de drogas lícitas.
- Armas de fogo : Conteúdo que discute o uso, a posse ou a distribuição de armas de fogo e outras armas, especialmente quando tais discussões podem promover ou causar violência ou práticas inseguras.
- Cibersegurança : Conteúdo relacionado à segurança de computadores, incluindo discussões sobre hacking, violações de dados e medidas para invadir sistemas digitais ou obter acesso não autorizado.
- Outros : Qualquer outro conteúdo considerado inadequado, prejudicial ou ofensivo que não esteja abrangido pelas categorias acima.
Definições de métricas
As métricas utilizadas nesta tarefa de moderação de texto são:
1. Matriz de Confusão : Uma tabela que resume o desempenho do modelo, exibindo:
- Verdadeiros Positivos (VP) : Textos que violam as regras e foram corretamente identificados como necessitando de moderação.
- Falsos Positivos (FP) : Textos que não violam as regras, mas que foram identificados incorretamente como necessitando de moderação.
- Verdadeiros Negativos (VN) : Textos que não violam as regras e foram corretamente identificados como não necessitando de moderação.
- Falsos negativos (FN) : Textos que violam as regras foram identificados incorretamente como não necessitando de moderação.
2. Precisão : A proporção de instâncias classificadas corretamente (tanto verdadeiros positivos quanto verdadeiros negativos) em relação ao número total de textos avaliados.
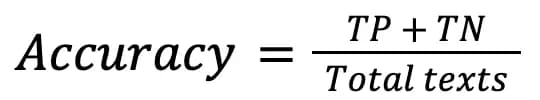
3. Taxa de Verdadeiros Negativos (TVN) : A proporção de instâncias negativas reais que são corretamente identificadas como negativas. No contexto da Moderação de Texto, a TVN mede o desempenho do modelo em textos que não violam as regras.
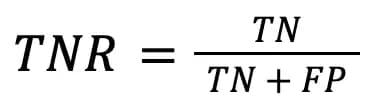
4. Taxa de Verdadeiros Positivos (TVP) / Recall : A proporção de instâncias realmente positivas que são corretamente identificadas como positivas. No contexto da Moderação de Texto, a TVP mede o desempenho do modelo em textos que violam as regras.
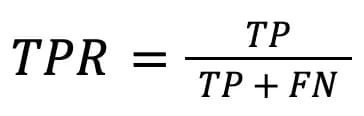
5. Precisão : A proporção de observações positivas previstas corretamente em relação ao total de previsões positivas. No contexto da Moderação de Texto, a Precisão mede a confiabilidade do modelo ao sinalizar conteúdo; ela indica quantos dos textos identificados como violadores pelo modelo foram de fato moderados.
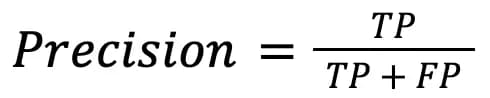
6. Pontuação F-beta : Uma média harmônica ponderada de precisão e revocação, onde o parâmetro beta é definido para favorecer a precisão. Essa priorização ajuda a alcançar uma taxa de falsos positivos menor.
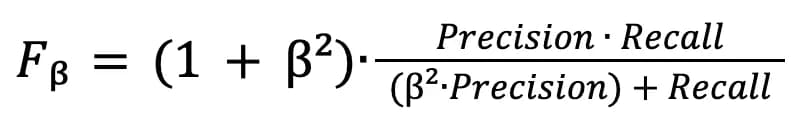
Resultados
Equipe de Ciência de Dados
Matriz de Confusão
Equipe de controle de qualidade
Resumo das métricas de teste de controle de qualidade:
Precisão geral : 0,9923
Precisão : 0,9997
Recorde : 0,9848
F-beta (β = 0,5) : 0,9967
Comparação direta
Limitações
- Âmbito linguístico: este modelo e sua avaliação abrangem apenas o inglês.
- Escopo contextual: a moderação é realizada em uma única "passagem" por vez, onde uma passagem é um bloco de texto autossuficiente com um determinado número de ocorrências. O sistema não mantém memória entre passagens, capítulos ou turnos de conversa; portanto, referências como "como explicamos anteriormente" ou pronomes que dependem de contexto anterior podem ser perdidas.
- Âmbito da modalidade: este produto avalia apenas texto; não foram incluídas entradas de imagem, áudio ou vídeo.